

O que é uma Data Clean Room
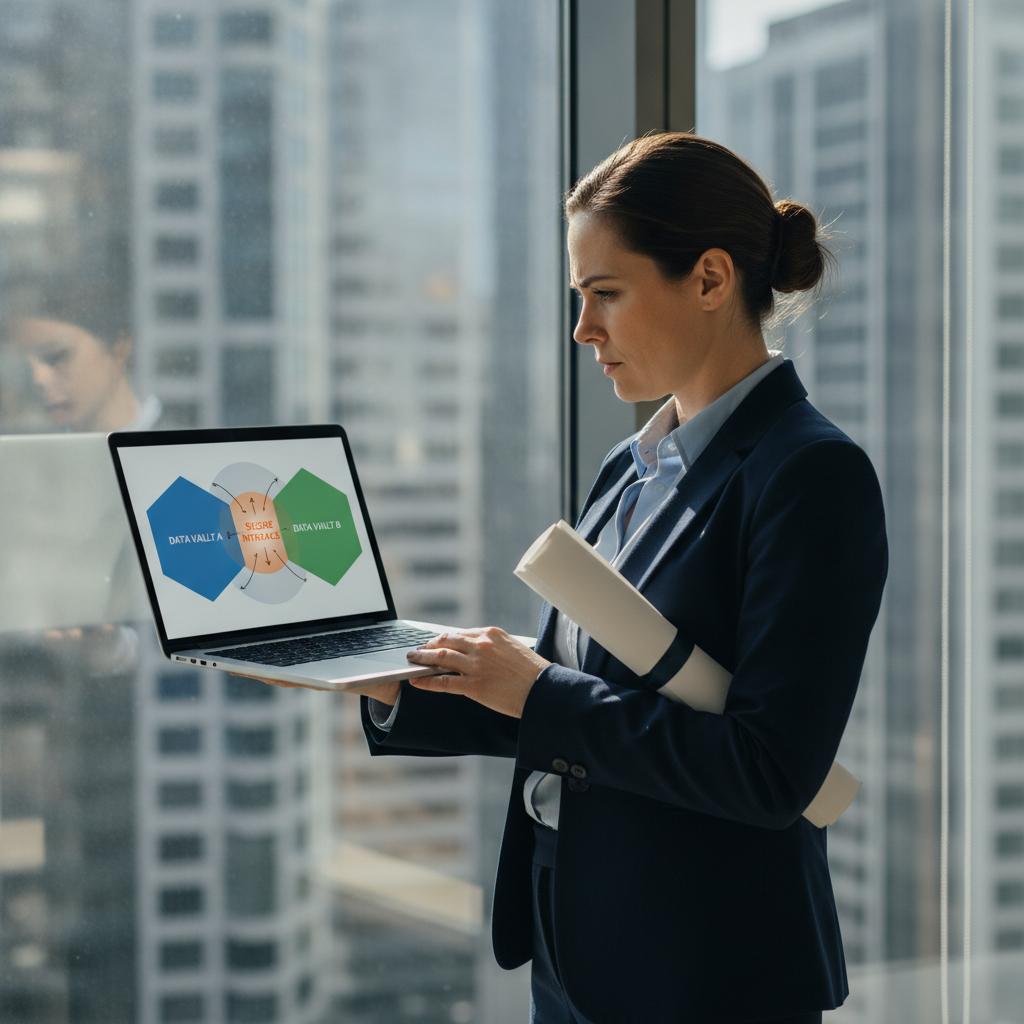
Uma Data Clean Room (DCR) é um ambiente tecnológico controlado onde duas ou mais partes executam análises conjuntas sobre seus dados sem que nenhuma delas tenha acesso direto aos dados brutos da outra. O resultado que sai do ambiente é sempre agregado ou anonimizado, nunca registros individuais identificáveis.
Isso é fundamentalmente diferente de trocar arquivos CSV, conceder acesso a um banco de dados ou usar uma API de sincronização. Nessas abordagens tradicionais, os dados trafegam entre as partes. Numa DCR, os dados ficam segregados dentro do ambiente e apenas as conclusões das consultas são liberadas.
O conceito não é novo, mas ganhou tração acelerada por dois fatores simultâneos: a depreciação progressiva dos cookies de terceiros nos principais navegadores e a vigência da LGPD no Brasil. Ambos os movimentos reduziram drasticamente a capacidade de rastrear usuários entre domínios, forçando marcas e publishers a buscar formas de colaborar com dados próprios sem violar privacidade ou compliance.
Como uma Data Clean Room funciona tecnicamente
O fluxo básico segue um padrão consistente independentemente da solução escolhida. Cada parte deposita seus dados no ambiente, geralmente via upload seguro ou conector direto com sua plataforma de dados. As consultas são executadas dentro do DCR, onde os datasets se cruzam. Apenas o resultado agregado da análise é exportado para fora do ambiente.
Um exemplo concreto: um varejista e um banco cruzam suas bases de clientes para entender sobreposição de audiência e comportamento de compra. Nenhum dos dois vê os registros individuais do outro. O que emerge é algo como “37% dos portadores do cartão X também compraram na categoria Y nos últimos 90 dias”.
Mecanismos de privacidade
As DCRs implementam diferentes camadas técnicas para garantir que resultados agregados não possam ser revertidos até o dado individual. As principais são:
- Anonimização e pseudonimização: identifiers como e-mail ou CPF são substituídos por hashes antes de entrar no ambiente.
- K-anonimato: nenhum resultado é liberado se o grupo analisado tiver menos de K indivíduos (valor típico entre 25 e 100), impedindo a identificação de outliers.
- Privacidade diferencial: técnica mais sofisticada que injeta ruído estatístico calibrado nos resultados, garantindo que a presença ou ausência de qualquer indivíduo específico não altere o output de forma detectável.
Controles de acesso e restrições de consulta
As DCRs também impõem restrições sobre quais consultas podem ser executadas. Queries que tentam isolar subgrupos muito pequenos, fazer joins não autorizados ou extrair campos específicos são bloqueadas por regras de governança configuradas no ambiente. Logs de auditoria registram todas as consultas executadas por ambas as partes.
Integração com o ecossistema existente
A maioria das soluções modernas oferece APIs e conectores nativos para CDPs, data warehouses e plataformas de ativação. Isso permite que os resultados das análises dentro da DCR alimentem segmentos em plataformas de mídia ou modelos de ML sem que os dados brutos saiam do ambiente controlado.
Principais tipos de Data Clean Room
DCR baseado em plataforma de nuvem
São ambientes oferecidos diretamente por provedores de infraestrutura de cloud. Exemplos desse modelo incluem soluções nativas de AWS, Google Cloud e Snowflake. A vantagem é que, se ambas as partes já operam no mesmo ecossistema de cloud, a latência e o custo de movimentação de dados são menores. A desvantagem é que o modelo pressupõe que ambos os parceiros estejam no mesmo provedor ou aceitem levar dados para um ambiente neutro.
DCR de mídia e retail media
Grandes publishers, redes de varejo e operadoras de telecomunicações constroem DCRs próprias para oferecer aos seus anunciantes e parceiros acesso seguro às suas audiências. O anunciante traz seus dados de CRM, o publisher traz sua base de usuários, e o cruzamento acontece dentro do ambiente controlado pelo publisher. É o modelo mais comum em retail media, onde varejistas monetizam o conhecimento sobre comportamento de compra.
DCR corporativo interno
Empresas com múltiplas subsidiárias, marcas ou áreas com restrições regulatórias diferentes utilizam DCRs internas para compartilhar dados entre unidades sem violar políticas de segmentação de dados. É comum em conglomerados financeiros onde banco, seguradora e corretora precisam colaborar respeitando regras de segredo bancário.
Diferenças práticas entre os modelos
DCRs de cloud tendem a ter maior flexibilidade técnica, mas exigem mais capacidade de engenharia para configurar. DCRs de mídia são mais simples de usar, mas a governança fica concentrada no publisher, o que cria assimetria de poder. DCRs internas têm menor complexidade contratual, mas exigem investimento em infraestrutura e ownership claro entre áreas.
Casos de uso mais comuns no mercado
Mensuração de campanhas cross-media
Anunciantes precisam entender o alcance e a frequência de suas campanhas considerando diferentes canais: TV conectada, streaming, display, redes sociais. Com uma DCR, é possível cruzar dados de exposição de diferentes publishers para calcular alcance único sem que nenhum deles veja os dados de audiência do outro.
Enriquecimento de first-party data
Uma fintech pode enriquecer seu CRM com dados de comportamento de compra de um parceiro varejista, e vice-versa, para melhorar modelos de propensão, risco de crédito ou personalização de ofertas. A DCR garante que esse enriquecimento aconteça de forma auditável e sem transferência direta de dados pessoais.
Modelagem de lookalike e segmentação avançada
Com os resultados agregados de uma DCR, é possível construir modelos de similaridade que identificam, na base do parceiro, perfis parecidos com os melhores clientes da própria empresa. O modelo é treinado dentro do ambiente e os segmentos são ativados sem expor identidades individuais.
Contexto brasileiro
No Brasil, as iniciativas mais avançadas de DCR estão concentradas em retail media: varejistas como grandes redes de supermercados e farmácias que constroem ambientes para oferecer seus dados de compra a marcas de bens de consumo. Parcerias entre bancos digitais e plataformas de e-commerce também experimentam esse modelo para ofertas conjuntas e análise de jornada de compra.
Limitações e pontos de atenção antes de adotar
Volume mínimo de dados
DCRs dependem de massa crítica. Cruzamentos com sobreposição muito pequena entre as bases, menos de alguns milhares de registros no segmento analisado, produzem resultados estatisticamente instáveis ou são simplesmente bloqueados pelos mecanismos de k-anonimato. Empresas com bases menores podem não se beneficiar dos casos de uso mais sofisticados.
Complexidade de governança
Antes de qualquer linha de código, é preciso definir contratualmente quem é o data controller de cada dataset, quais finalidades são permitidas, quem pode executar quais tipos de consulta e como disputas de interpretação dos resultados são resolvidas. Essa negociação entre áreas jurídicas e de compliance costuma ser o gargalo real de um projeto de DCR.
Risco de lock-in
Quando a DCR é operada exclusivamente pela outra parte, um publisher ou um parceiro comercial, há dependência estrutural. Se a relação comercial se deteriorar, o acesso ao ambiente e aos históricos de análise pode ser interrompido. Avaliar a portabilidade dos resultados e a neutralidade do operador é essencial antes de assinar qualquer acordo.
Conformidade com a LGPD
Um ambiente tecnicamente seguro não resolve sozinho as obrigações legais. Mesmo dentro de uma DCR, os dados precisam ter base legal definida para o processamento específico que será realizado: consentimento, legítimo interesse ou execução de contrato. As finalidades do cruzamento devem ser compatíveis com as finalidades originais de coleta de cada parte, sob pena de violação do princípio da finalidade da LGPD.
Como avaliar se sua empresa está pronta para um DCR
Checklist de maturidade
Antes de avaliar qualquer solução, responda internamente:
- Qualidade do first-party data: sua base tem taxa de match aceitável com hashes de e-mail ou CPF? Dados sujos ou desatualizados reduzem drasticamente a sobreposição real.
- Caso de uso definido: existe uma pergunta de negócio específica que a DCR vai responder? Projetos iniciados sem hipótese clara raramente geram valor.
- Capacidade técnica interna: há engenheiros de dados ou analistas capazes de escrever as consultas e interpretar os resultados agregados?
- Parceiro com dados complementares: existe um parceiro disposto a colaborar e com base de dados relevante para o seu negócio?
Perguntas a fazer ao avaliar soluções ou parceiros
- Quem controla o ambiente tecnicamente — você, o parceiro ou um terceiro neutro?
- Quais mecanismos de privacidade são aplicados e como eles são auditáveis?
- É possível exportar os históricos de consulta e os metadados do projeto se a parceria encerrar?
- O ambiente tem certificações de segurança (SOC 2, ISO 27001) e oferece logs de auditoria acessíveis a ambas as partes?
- Qual é o volume mínimo de sobreposição exigido para que as consultas retornem resultados?
Alternativas para estágios iniciais
Se sua empresa ainda não tem first-party data estruturado ou capacidade técnica para operar uma DCR, existem abordagens menos complexas para começar a colaborar com dados de parceiros. Acordos de compartilhamento de métricas agregadas via relatórios fechados, uso de identificadores compartilhados como RampID da LiveRamp, UID2 da The Trade Desk ou integrações via plataformas de dados comuns são pontos de entrada válidos antes de investir na infraestrutura e governança de uma DCR completa.



