

O que é identity resolution
Identity resolution é o processo de vincular registros dispersos que pertencem a um mesmo indivíduo real, consolidando-os em um perfil unificado e persistente. Em vez de tratar cada interação como um evento isolado, o sistema reconhece que o mesmo Paulo que abriu um e-mail no desktop também navegou pelo app no celular e ligou para o SAC na semana seguinte.
A confusão mais comum é equiparar identity resolution à deduplicação simples. Deduplicar remove registros idênticos ou quase idênticos dentro de um único sistema — útil, mas limitado. Identity resolution vai além: cruza fontes heterogêneas, reconcilia identificadores distintos e mantém o grafo de relacionamento atualizado à medida que novos dados chegam.
O problema existe porque o comportamento digital fragmentou a identidade do consumidor em dezenas de pontos de contato. Um único usuário pode ter dois e-mails cadastrados, três dispositivos ativos, um ID de cookie por navegador e um cadastro no CRM feito por telefone, sem nenhum campo em comum entre todos esses registros. A tarefa da identity resolution é costurar esses fragmentos sem introduzir erros que contaminem a base.
Como o processo funciona na prática
Coleta de sinais
O ponto de partida é a ingestão de atributos que possam servir como âncoras de identidade: endereço de e-mail, número de telefone, CPF, cookie de navegador, Mobile Advertising ID (MAID), endereço IP, nome combinado com CEP, entre outros. Cada atributo tem grau de confiabilidade diferente — um e-mail confirmado vale mais do que um cookie de sessão anônima.
Quanto maior a variedade de sinais coletados, maior a cobertura do matching. Mas variedade sem qualidade gera ruído. A etapa de normalização — padronizar formatos de telefone, remover variações de nome, tratar maiúsculas — precede qualquer tentativa de vinculação.
Matching determinístico versus probabilístico
O matching determinístico compara identificadores exatos: dois registros com o mesmo e-mail confirmado pertencem à mesma pessoa. A precisão é alta, mas a cobertura é limitada — nem todo visitante fornece um e-mail, e o mesmo usuário pode usar endereços diferentes em canais distintos.
O matching probabilístico usa similaridade estatística para inferir que dois registros pertencem ao mesmo indivíduo, mesmo sem um campo em comum. Modelos consideram combinações de atributos — mesmo dispositivo, mesma faixa de IP, padrão de horário de acesso — e atribuem um score de confiança ao vínculo. A cobertura aumenta, mas o risco de falso positivo também.
Na prática, sistemas maduros combinam as duas abordagens em cascata: determinístico primeiro para os casos de alta certeza, probabilístico para preencher as lacunas restantes, com limiares de confiança configuráveis por caso de uso.
O identity graph como estrutura central
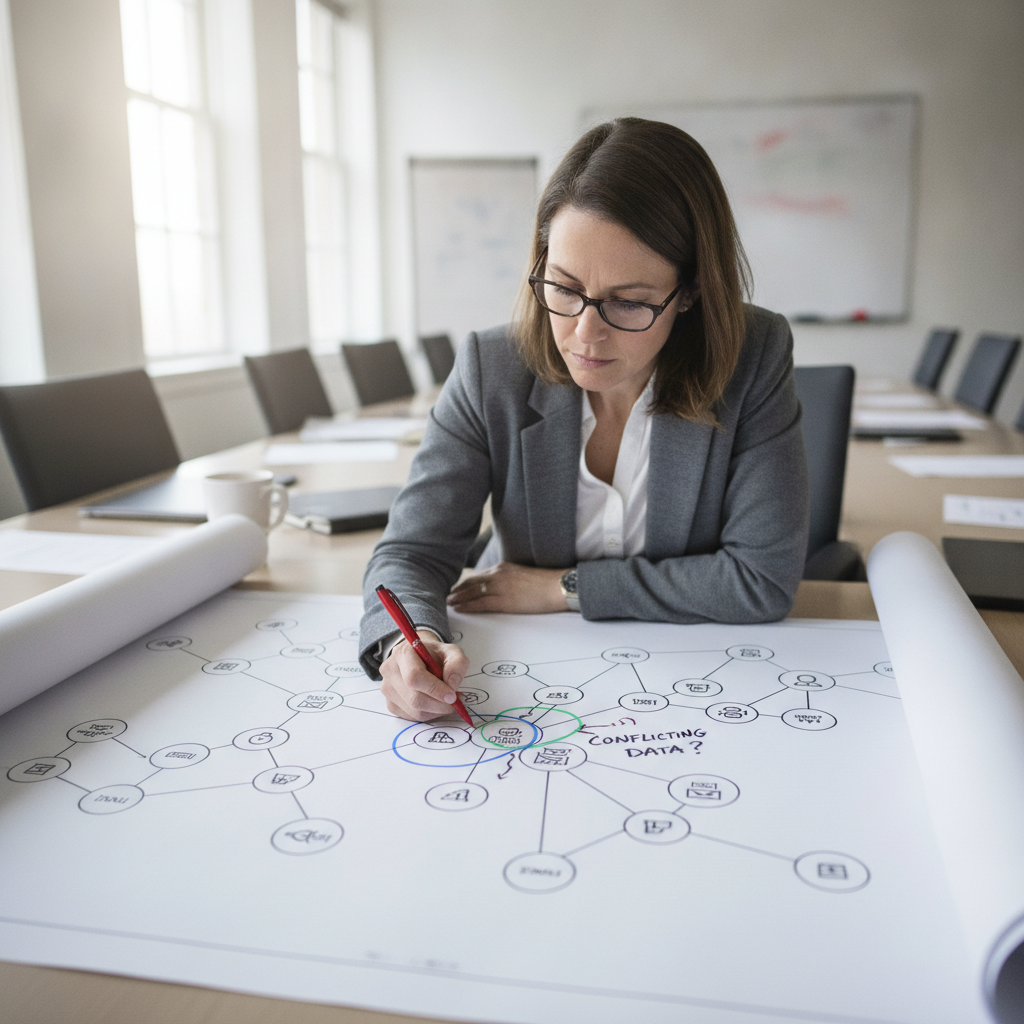
O resultado do processo de matching é armazenado em um identity graph: uma estrutura de grafo em que os nós representam identificadores individuais (e-mails, cookies, dispositivos) e as arestas representam os vínculos estabelecidos entre eles, com metadados de confiança e origem. Quando um novo sinal chega, o sistema avalia se ele já existe no grafo ou se deve criar um novo nó, e se alguma aresta precisa ser criada ou fortalecida.
Manter o grafo é tão importante quanto construí-lo. Vínculos antigos perdem relevância, identificadores expiram e o comportamento do usuário muda. Um grafo sem política de decaimento acumula conexões obsoletas que distorcem a visão do cliente.
Por que a complexidade cresce com o volume
Com milhares de registros, o matching manual ou por regras simples ainda funciona. Com dezenas de milhões, o número de comparações possíveis cresce de forma quadrática. Algoritmos de blocking — que agrupam candidatos plausíveis antes de comparar — são indispensáveis para tornar o processo computacionalmente viável sem sacrificar qualidade.
A ambiguidade também aumenta na mesma proporção: nomes comuns, e-mails corporativos compartilhados e cadastros incompletos elevam a taxa de colisão, casos em que o sistema não consegue determinar com segurança se dois registros são a mesma pessoa ou pessoas diferentes.
Casos de uso principais
Single Customer View para personalização
A visão unificada do cliente é o caso de uso mais citado. Com um perfil consolidado, campanhas de e-mail, push, mídia paga e atendimento humano operam a partir dos mesmos dados comportamentais e transacionais, sem a inconsistência de tratar o mesmo cliente como se fosse três pessoas diferentes dependendo do canal.
Atribuição de jornada cross-channel
Sem identity resolution, a atribuição de conversão enxerga jornadas cheias de lacunas. O modelo credita o último clique no desktop sem saber que o processo começou em um anúncio no mobile três dias antes. Ao conectar os dispositivos ao mesmo perfil, a atribuição passa a refletir a jornada real e distribui crédito de forma mais precisa entre os canais envolvidos.
Supressão de contatos convertidos
Investir em mídia paga para reimpactar um cliente que já converteu é desperdício direto. Listas de supressão baseadas em perfil unificado garantem que o cliente identificado como “convertido” seja excluído das campanhas de prospecção, independentemente do dispositivo ou canal pelo qual ele navegou.
Detecção de fraude
O mesmo mecanismo que reconhece um cliente legítimo em múltiplos canais também pode sinalizar comportamentos suspeitos, como um mesmo dispositivo tentando criar várias contas com e-mails diferentes ou padrões de cadastro que correspondem a contas já bloqueadas. Identity resolution aplicada à prevenção de fraude reduz o abuso sem aumentar o atrito para usuários legítimos.
Desafios técnicos e operacionais
Ausência de identificador compartilhado
O cenário mais difícil é quando dois registros pertencem ao mesmo usuário, mas não têm nenhum campo em comum — um cadastro de e-commerce com e-mail A e um cadastro de newsletter com e-mail B, sem CPF em nenhum dos dois. Nesse caso, o matching probabilístico precisa se basear em sinais fracos como comportamento de navegação e localização aproximada, aumentando o risco de erro.
A solução estrutural é incentivar o usuário a se identificar com um identificador forte — login, CPF ou telefone — em todos os pontos de contato. Isso reduz a dependência de inferência probabilística e melhora a qualidade do grafo.
Degradação dos dados ao longo do tempo
E-mails mudam, telefones são trocados, cookies expiram, dispositivos são substituídos. Um grafo de identidade sem política de atualização e decaimento acumula vínculos que já não refletem a realidade, e pode até criar confusão ao mesclar perfis de pessoas diferentes que herdaram o mesmo número de telefone.
Escalabilidade dos algoritmos de matching
Algoritmos que produzem resultados aceitáveis em bases de um milhão de registros podem se tornar inviáveis em bases de cem milhões. A escolha de técnicas de indexação, blocking e processamento distribuído impacta diretamente a latência de atualização do perfil e, consequentemente, a relevância das decisões de personalização feitas em tempo real.
Governança de confiança nos vínculos
Todo sistema de identity resolution precisa definir limiares: qual score mínimo de confiança justifica criar uma aresta no grafo? Limiares baixos demais aumentam falsos positivos — clientes diferentes tratados como um só. Limiares altos demais aumentam falsos negativos — o mesmo cliente tratado como múltiplas pessoas. O equilíbrio depende do caso de uso e do custo de cada tipo de erro.
Identity resolution, privacidade e LGPD
Base legal para consolidação de dados
Consolidar dados de diferentes fontes sem consentimento explícito exige base legal sólida. A LGPD prevê hipóteses como legítimo interesse e execução de contrato, mas o uso de dados para construção de perfis comportamentais — especialmente com cruzamento de fontes externas — pode não se enquadrar facilmente nessas bases sem análise jurídica cuidadosa e, em muitos casos, registro de impacto de proteção de dados (RIPD).
Impacto do fim dos third-party cookies
Grande parte do matching probabilístico baseado em navegador dependia de cookies de terceiros para sincronizar IDs entre domínios. Com o bloqueio progressivo desses cookies pelos principais navegadores, estratégias que antes funcionavam em escala passam a depender cada vez mais de dados first-party — e-mail coletado em cadastro, login autenticado, dados de CRM — o que reforça a importância de programas de captação de dados com consentimento explícito.
Boas práticas de privacidade by design
Minimização de dados significa coletar apenas o que é necessário para a finalidade declarada. Pseudonimização — substituir identificadores diretos por tokens internos antes de armazená-los no grafo — reduz o risco em caso de vazamento e facilita o atendimento ao direito de exclusão do titular. Transparência com o titular inclui informar, na política de privacidade, que dados de diferentes fontes são consolidados e para quais fins.
Contexto brasileiro e ANPD
A Autoridade Nacional de Proteção de Dados (ANPD) ainda está consolidando orientações específicas sobre perfilamento, mas resoluções e notas técnicas já publicadas indicam atenção especial a práticas que combinam dados de fontes distintas sem clareza de finalidade. Empresas que operam identity resolution no Brasil devem acompanhar as publicações da ANPD e manter documentação das decisões de design de privacidade que justificaram as escolhas técnicas adotadas.
Como avaliar uma capacidade de identity resolution
Critérios técnicos
Latência de atualização do perfil: quanto tempo leva entre a chegada de um novo sinal e a atualização do identity graph? Para casos de uso em tempo real — personalização de site, decisão de oferta no momento da ligação — latências acima de alguns segundos podem inviabilizar o caso de uso.
Cobertura de atributos: quais identificadores o sistema suporta nativamente? Ele processa CPF, telefone no formato brasileiro e identificadores de plataformas de anúncio relevantes no mercado local?
Auditabilidade das decisões de match: é possível rastrear por que dois registros foram vinculados — quais atributos contribuíram e qual foi o score de confiança? Sem auditabilidade, corrigir erros e responder a questionamentos do titular de dados se torna muito mais difícil.
Integração com o stack existente
A capacidade de identity resolution não existe no vácuo. Ela precisa receber dados do CRM, do CDP, das plataformas de e-commerce e dos sistemas de atendimento, e devolver perfis enriquecidos para as ferramentas de ativação. Avalie se as APIs e conectores disponíveis cobrem os sistemas já em uso, e qual o custo de manutenção dessas integrações ao longo do tempo.
Perguntas essenciais antes de adotar qualquer solução
- Quem detém o identity graph? O grafo fica armazenado no ambiente do fornecedor ou no ambiente do cliente? Em caso de encerramento do contrato, como os dados são exportados?
- Como o sistema trata conflitos? Quando dois registros são erroneamente mesclados, qual o processo para separar os perfis e corrigir os dados downstream?
- Qual o modelo de atualização? Batch diário, near real-time ou streaming contínuo — e qual o impacto de cada escolha no custo operacional?
- Como o fornecedor lida com dados sensíveis? CPF, por exemplo, exige cuidados adicionais de segurança e tratamento conforme a LGPD.
Métricas de sucesso
Taxa de match mede a proporção de registros que foram vinculados a um perfil consolidado. Uma taxa muito baixa indica cobertura insuficiente; uma taxa suspeitamente alta pode indicar fusões indevidas.
Taxa de duplicatas residuais mede quantos perfis duplicados ainda existem após o processo, identificável por auditorias amostrais. Essa métrica revela a eficácia real do matching sem depender dos próprios algoritmos para se autoavaliar.
Impacto mensurável em receita ou eficiência é o teste final. Redução de custo por aquisição pela supressão de convertidos, aumento de taxa de conversão por personalização mais precisa e redução de churn por reconhecimento correto do cliente no atendimento são exemplos de KPIs que conectam a operação de identity resolution a resultados de negócio tangíveis.



