O que é uma stack de dados para e-commerce
Uma stack de dados para e-commerce é o conjunto de ferramentas, processos e integrações responsável por coletar, armazenar, transformar e disponibilizar os dados do negócio para quem precisa tomar decisões. Não é um produto único: é uma arquitetura composta por camadas que trabalham em sequência.
Separar esse conceito da stack tecnológica operacional do e-commerce é essencial. Plataforma de loja (VTEX, Shopify, Magento), ERP, gateway de pagamento e sistema de logística são ferramentas que geram dados. A stack de dados é o que coleta esses dados dispersos, consolida e os torna úteis para análise, personalização e automação.
Cada ferramenta da operação entrega seus próprios relatórios nativos: a plataforma mostra pedidos, o Meta Ads mostra impressões, o CRM mostra aberturas de e-mail. O problema é que esses silos não se falam. Sem uma stack de dados dedicada, a operação toma decisões com visões parciais, frequentemente inconsistentes entre si.
A maioria das operações brasileiras de e-commerce ainda está nos estágios iniciais de maturidade: dependem de relatórios nativos das plataformas e de planilhas consolidadas manualmente. O uso preditivo, como churn, propensão a compra e otimização de estoque, é realidade para uma minoria. O ponto de partida importa mais do que o destino final.
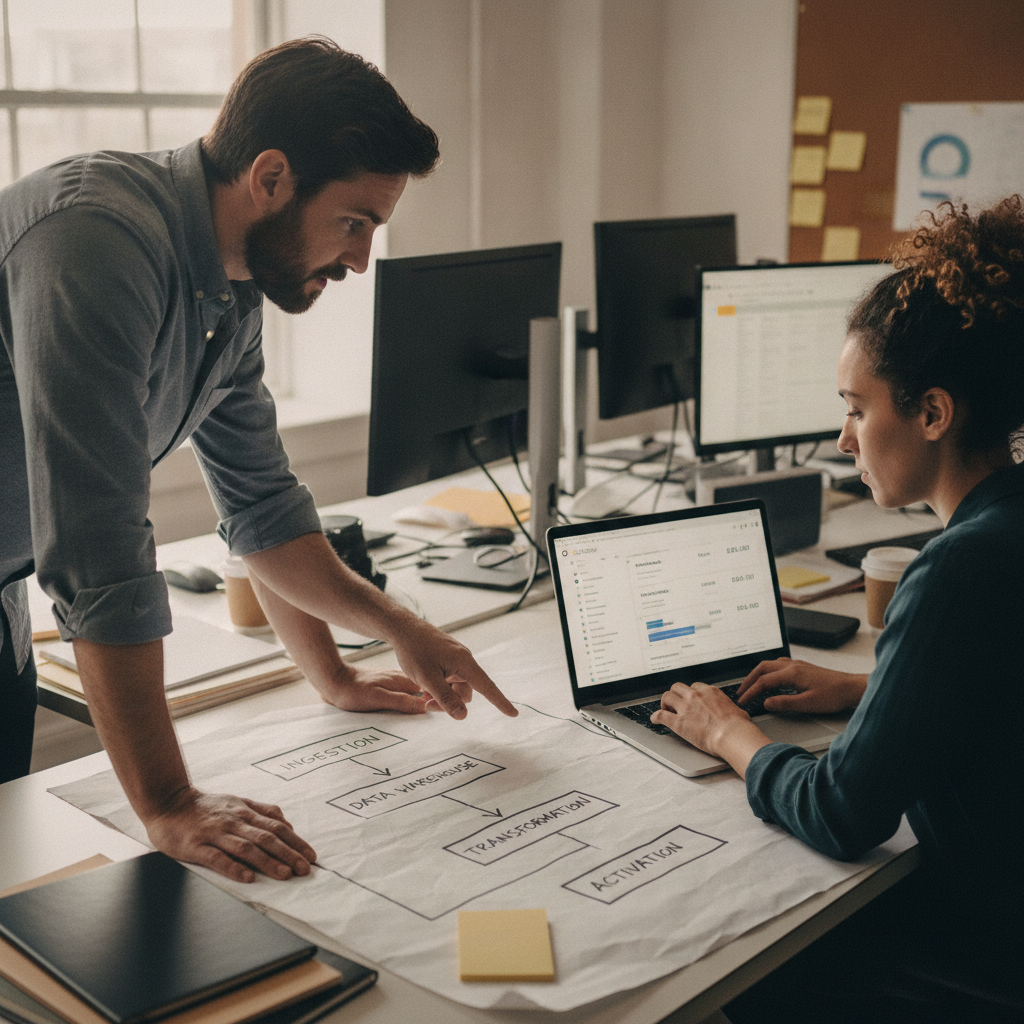
Camadas essenciais da stack: da coleta ao consumo
Camada de ingestão
É onde os dados entram na stack. No e-commerce, isso envolve duas frentes principais: rastreamento de eventos na loja (cliques, visualizações de produto, adições ao carrinho, pedidos finalizados, abandonos) e integração com sistemas externos como plataformas de loja, ERPs e marketplaces.
O rastreamento de eventos pode ser feito via JavaScript no frontend, server-side ou ambos. A integração com plataformas como VTEX, Shopify ou Magento costuma ocorrer via API ou conectores prontos. Marketplaces como Mercado Livre e Shopee têm APIs próprias, com diferentes níveis de granularidade nos dados que expõem.
Camada de armazenamento
Os dados ingeridos precisam de um destino centralizado. Para a maioria das operações de e-commerce, um data warehouse é suficiente: BigQuery, Redshift e Snowflake são as opções mais comuns no mercado. Operações com alto volume de dados não estruturados, como logs, imagens e áudio de SAC, podem considerar uma arquitetura lakehouse.
O princípio aqui é simples: dados brutos chegam e são armazenados sem transformação. Isso preserva o histórico e permite reprocessamento futuro caso a lógica de negócio mude.
Camada de transformação
Dados brutos raramente chegam prontos para análise. A camada de transformação aplica lógica de negócio: calcula receita líquida descontando devoluções, consolida pedidos do marketplace com pedidos da loja própria, cria a visão unificada do cliente. Ferramentas como dbt são amplamente usadas para organizar essas transformações em SQL versionado e testável. Scripts Python complementam casos que SQL não resolve bem.
Camada de ativação e consumo
É onde os dados transformados geram valor para o negócio. Ferramentas de BI (Looker, Metabase, Power BI) consomem os dados para dashboards e relatórios. CDPs usam o perfil unificado do cliente para segmentação e personalização. Ferramentas de CRM e automação de marketing recebem os segmentos e disparam comunicações baseadas em comportamento real de compra.
Fontes de dados mais críticas no e-commerce
Dados transacionais
Pedidos, itens do pedido, valor, forma de pagamento, status de entrega e devoluções formam a espinha dorsal de qualquer análise de e-commerce. São os dados mais confiáveis e geralmente os mais fáceis de obter via API da plataforma ou exportação do ERP. A consistência entre essas fontes é frequentemente um problema: o valor do pedido na plataforma nem sempre bate com o que o ERP registra após aplicar regras fiscais.
Dados comportamentais
Sessões, páginas visitadas, funil de navegação, buscas internas, scroll depth e mapas de calor revelam a intenção do usuário antes da conversão. São dados essenciais para otimização de conversão e personalização, mas também os mais sensíveis do ponto de vista de privacidade: exigem consentimento explícito sob a LGPD.
Dados de mídia paga
Custo, cliques, impressões e conversões atribuídas de Meta Ads, Google Ads, marketplaces e afiliados precisam estar na stack para qualquer análise de ROAS e eficiência de aquisição. O desafio é a fragmentação: cada plataforma tem seu próprio modelo de atribuição, e cruzar esses dados com os pedidos reais da loja exige um identificador comum e muito cuidado metodológico.
Dados de cliente
Cadastro, histórico completo de compras, interações com atendimento (tickets, avaliações), NPS e respostas a campanhas compõem o perfil do cliente. Quando consolidados, permitem calcular LTV, identificar clientes em risco de churn e criar segmentações muito mais precisas do que as baseadas apenas no último pedido.
Estoque e supply chain
Disponibilidade de SKU em tempo real, lead time de reposição e ruptura de estoque são dados frequentemente ignorados na stack, mas têm impacto direto em campanhas de mídia (não faz sentido investir em tráfego para produto em ruptura) e em recomendações personalizadas. A integração com ERP ou WMS é o caminho mais comum para obtê-los.
Arquiteturas comuns: qual faz sentido para cada porte
Stack mínima viável
Para operações pequenas, com até algumas dezenas de pedidos por dia e um ou dois canais de venda, uma stack simples já resolve: Google Analytics 4 para comportamento, dados transacionais exportados da plataforma para planilhas e um CRM básico para comunicação. O limite dessa abordagem aparece rápido: consolidação manual é cara em tempo e propensa a erro.
Stack intermediária
Com crescimento de volume e canais, faz sentido introduzir uma ferramenta de integração ELT (Fivetran, Airbyte ou similar) para automatizar a ingestão, um data warehouse gerenciado (BigQuery ou Redshift) como destino central e uma ferramenta de BI dedicada conectada a ele. Essa arquitetura já permite análises consistentes, automatizadas e auditáveis, e é onde a maioria das operações maduras deveria estar.
Stack avançada
Operações de grande porte, com alto volume de pedidos por dia e múltiplos canais, podem evoluir para streaming de eventos em tempo real (para personalização e alertas instantâneos), um CDP centralizado para unificação de identidade cross-canal e orquestração de pipelines com ferramentas como Airflow ou Dagster para gerenciar dependências entre processos.
Como escolher
O critério principal não é tamanho da empresa: é a combinação de volume de pedidos por dia, quantidade de canais de venda e capacidade interna de engenharia de dados. Uma operação com 500 pedidos/dia em canal único e sem engenheiro de dados não precisa de streaming em tempo real. Uma com 50 pedidos/dia em seis canais diferentes já sente a dor da fragmentação.
A armadilha mais comum é adotar ferramentas enterprise, como CDPs complexos e plataformas de orquestração sofisticadas, antes de ter dados confiáveis e processos básicos consolidados. Ferramenta cara sobre dado ruim só gera custo, não resultado.
Desafios práticos no contexto brasileiro
Fragmentação de canais
Vender simultaneamente em Mercado Livre, Shopee, loja própria e Instagram Shopping é a realidade de muitos e-commerces brasileiros. Cada canal tem sua API, seu modelo de dados e sua forma de identificar o cliente. Unificar pedidos e clientes entre esses canais é um trabalho de engenharia não trivial, frequentemente subestimado no planejamento da stack.
Qualidade do dado fiscal
NF-e, dados de ERP e plataforma de e-commerce raramente estão sincronizados. Devoluções, cancelamentos e trocas criam divergências que precisam ser reconciliadas antes de qualquer análise financeira confiável. Ignorar essa reconciliação é receita para dashboards bonitos com números errados.
LGPD
A coleta de dados comportamentais, incluindo cookies, eventos de navegação e pixels de terceiros, exige consentimento explícito e uma política de retenção definida. A stack precisa contemplar mecanismos de opt-out, exclusão de dados e segregação de dados sensíveis. Isso não é opcional e afeta diretamente como o rastreamento é implementado.
Custo de infraestrutura
Serviços gerenciados de cloud são cobrados em dólar. Para operações com receita em real, o custo de um data warehouse gerenciado ou de um CDP SaaS pode ser significativo. A decisão entre managed service e self-hosted deve levar em conta não só o custo de infraestrutura, mas também o custo operacional de manter e escalar uma solução própria, que geralmente é maior do que parece no início.
Por onde começar: passos práticos para estruturar a stack
Mapeie as perguntas de negócio antes de escolher qualquer ferramenta. “Qual é o LTV por canal de aquisição?” ou “Qual categoria tem maior taxa de devolução?” são perguntas que definem quais dados são prioritários. Começar pela ferramenta é começar pelo meio.
Garanta rastreamento de eventos confiável na loja. Sem eventos consistentes, como visualização de produto, adição ao carrinho, início de checkout e pedido confirmado, não há funil de conversão analisável. Essa é a base inegociável. Valide os eventos contra os pedidos reais da plataforma antes de avançar.
Centralize os dados transacionais em um único destino e valide. Conecte a plataforma de e-commerce, o ERP e os principais marketplaces a um destino central. Antes de criar qualquer dashboard ou segmentação, compare os totais do destino central com os relatórios nativos de cada fonte. Divergências precisam ser explicadas e resolvidas.
Evolua de forma incremental. Adicione camadas à stack somente quando a anterior estiver estável e sendo consumida ativamente pelo time. Ingestão automatizada sem transformação confiável é dado bruto sem uso. Transformação sem consumo é custo de engenharia sem retorno. Cada camada deve provar seu valor antes de justificar a próxima.
Defina ownership claro. Stack de dados sem responsável é stack que ninguém mantém. Mesmo em operações pequenas, alguém precisa ser o guardião da confiabilidade dos dados, seja um analista, um engenheiro ou um gerente de operações com perfil técnico. Sem ownership, a qualidade se degrada silenciosamente até que ninguém confia mais nos números.