O que é prevenção de churn com IA e por que vai além do score
A maioria das empresas ainda opera em modo reativo: percebe o cancelamento depois que ele acontece, analisa os dados históricos e tenta entender o que deu errado. A prevenção preditiva inverte essa lógica. O modelo identifica clientes com alta probabilidade de sair antes que eles tomem a decisão, abrindo uma janela de intervenção.
Essa diferença importa porque o custo de reconquistar um cliente perdido costuma ser três a cinco vezes maior do que o de retê-lo. Churn reativo trata o sintoma; churn preditivo ataca a causa enquanto ainda há tempo.
Regras manuais (“cliente sem login há 30 dias recebe e-mail automático”) funcionam em bases pequenas. Conforme a empresa cresce e diversifica o portfólio, essas regras se multiplicam, conflitam entre si e produzem alertas irrelevantes. O time de Customer Success perde tempo investigando falsos positivos em vez de agir sobre risco real.
A IA entra como uma camada de análise contínua que processa dezenas de variáveis simultaneamente, identifica padrões não lineares e atualiza as pontuações à medida que o comportamento do cliente muda. Não substitui o julgamento humano: estrutura onde ele deve ser aplicado.
Sinais e dados que alimentam modelos de churn
A qualidade do modelo depende diretamente da qualidade e diversidade dos dados de entrada. Empresas que alimentam o modelo apenas com dados de faturamento constroem uma visão tardia do problema: quando a inadimplência aparece, o cliente frequentemente já decidiu sair.
Dados comportamentais
Frequência de login, profundidade de sessão, uso de features críticas, taxa de adoção de funcionalidades novas e volume de usuários ativos dentro de uma conta (em modelos B2B) são os sinais mais precoces de deterioração de engajamento. Uma queda consistente nesses indicadores ao longo de duas a quatro semanas precede o cancelamento com antecedência suficiente para intervenção.
Segmentar comportamento por perfil de uso esperado é essencial. Um cliente que nunca usou determinada feature não está em risco por isso — já um cliente que a usava semanalmente e parou pode estar.
Dados transacionais e contratuais
Downgrade de plano, renovação tardia, solicitação de pausa ou desconto, redução no volume de uso contratado e inadimplência recorrente são sinais transacionais de alto valor preditivo. No contexto de SaaS B2B, a não expansão de licenças em contas que historicamente cresciam também é um indicador relevante.
Dados de suporte
Volume de tickets abertos, tempo médio de resolução, reaberturas e, principalmente, sentimento nas interações de suporte (via análise de texto ou NPS) compõem uma dimensão que muitas empresas subutilizam. Um cliente que abre três tickets em uma semana e recebe resoluções lentas tem probabilidade de churn significativamente maior do que a média.
Sinais externos relevantes no contexto brasileiro
Sazonalidade econômica afeta churn de forma pronunciada no Brasil. Produtos B2C e PMEs são sensíveis a ciclos de crédito, variação do dólar (especialmente em SaaS com pricing em USD ou atrelado ao câmbio) e períodos como virada de ano e férias escolares. Incorporar esses sinais macroeconômicos como variáveis contextuais melhora a acurácia do modelo em janelas de stress econômico.
Principais abordagens de IA aplicadas ao churn
Modelos de classificação supervisionada
A abordagem mais comum. O modelo aprende com histórico de clientes que cancelaram e que permaneceram, identificando quais combinações de variáveis precederam o churn. Regressão logística oferece interpretabilidade e funciona bem em bases menores. Gradient boosting (XGBoost, LightGBM) captura relações não lineares e costuma performar melhor em dados tabulares mistos. Redes neurais ganham relevância quando há volume alto de dados e features brutas como texto ou sequências de eventos.
O output é um score de probabilidade de churn em um horizonte definido, geralmente 30, 60 ou 90 dias. A escolha do horizonte deve refletir o ciclo de vendas e o tempo necessário para que a intervenção surta efeito.
Modelos de sobrevivência
Em vez de responder “este cliente vai cancelar?”, modelos de sobrevivência (Cox Proportional Hazards, Weibull, entre outros) respondem “quando este cliente tende a cancelar?”. Essa distinção é valiosa para priorizar intervenções: dois clientes com probabilidade similar de churn podem ter horizontes muito diferentes, e o urgente precisa de atenção agora.
Modelos de sobrevivência lidam nativamente com dados censurados, ou seja, clientes ainda ativos cujo desfecho é desconhecido, o que os torna metodologicamente mais adequados em determinados cenários.
Segmentação não supervisionada
Quando a base é nova ou o histórico de cancelamentos é insuficiente para treinar um modelo supervisionado, clustering (K-means, DBSCAN, modelos de mistura gaussiana) permite identificar grupos de comportamento distinto. Ao comparar as características dos clusters com benchmarks externos ou com os poucos churns disponíveis, é possível inferir quais segmentos têm perfil de risco elevado sem rótulo histórico suficiente.
Quando cada abordagem faz sentido
Empresas com menos de 12 meses de dados ou base abaixo de alguns milhares de clientes devem começar com regras enriquecidas e segmentação não supervisionada. A partir de uma base histórica representativa de eventos de churn, modelos supervisionados passam a ser viáveis. Modelos de sobrevivência fazem mais sentido quando o negócio tem contratos de duração variável ou quando o timing da intervenção é crítico para a estratégia de CS.
Da pontuação de risco à ação: como fechar o ciclo
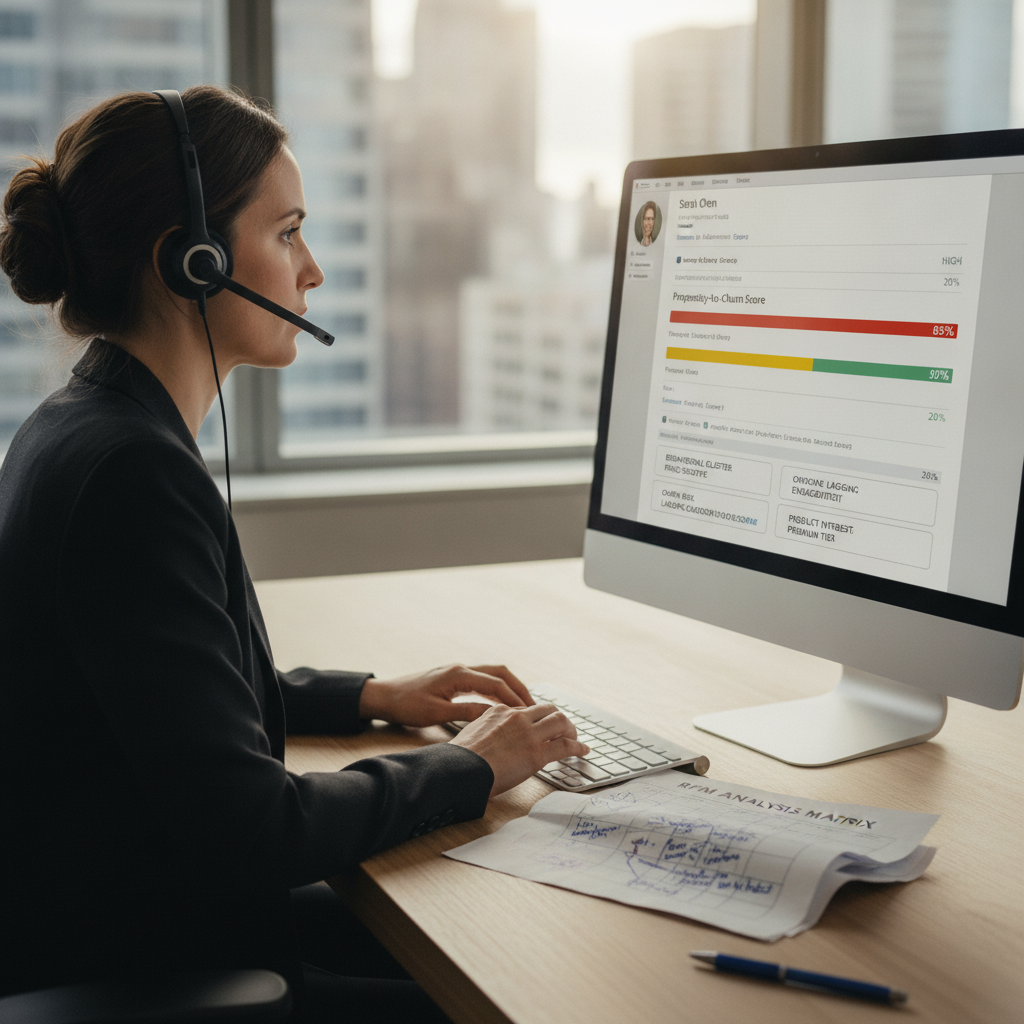
Um score de churn sem playbook associado é apenas um número. O ciclo só se fecha quando o output do modelo gera uma ação específica, executada pela equipe ou sistema correto, no momento adequado.
Transformando score em gatilho
O score precisa ser consumido por ferramentas operacionais, como CRM, plataforma de CS, CDP ou automação de marketing, para gerar tarefas, alertas ou fluxos automatizados. A integração via API ou webhook em tempo quase real é preferível a exportações batch diárias, especialmente em bases onde o comportamento muda rapidamente.
Personalização da intervenção por segmento
Nem todo risco exige contato humano. Clientes com score médio e comportamento de baixo engajamento respondem bem a sequências automatizadas de reativação: conteúdo educativo, destaque de features subutilizadas, ofertas contextuais. Clientes de alto valor com score crítico merecem contato direto de um CS sênior. A segmentação da intervenção reduz custo operacional e evita a percepção de assédio por parte do cliente.
Regras de negócio que protegem a experiência
Intervenções excessivas ou mal calibradas podem antecipar o cancelamento em vez de evitá-lo. Um cliente que recebe cinco contatos em duas semanas por “estar em risco” pode se sentir pressionado a tomar uma decisão que ainda não havia considerado. Definir cooldown entre interações, limitar canais por segmento e registrar histórico de intervenções anteriores são regras de negócio essenciais que devem ser configuradas na camada de orquestração, não no modelo.
Integração com CDP e automação
O score de churn deve ser um atributo do perfil unificado do cliente no CDP, não um dado isolado em uma ferramenta de analytics. Essa integração permite que qualquer sistema downstream (e-mail, push, CRM, suporte) acesse o nível de risco atualizado e tome decisões consistentes, eliminando silos onde o time de marketing envia campanha de upsell para um cliente que o CS está tentando reter.
Armadilhas comuns na implementação
Viés de sobrevivência e bases pequenas
Treinar o modelo apenas com clientes que ainda estão na base, ignorando os que já cancelaram há mais tempo e saíram do dataset, cria viés de sobrevivência. O modelo aprende o que caracteriza clientes que permaneceram, não o que diferencia quem sai de quem fica. É preciso montar o dataset incluindo todos os clientes relevantes no período analisado, independentemente de ainda estarem ativos.
Bases pequenas amplificam o problema: com poucos eventos de churn, o modelo tende a memorizar padrões específicos que não generalizam. Técnicas de oversampling (SMOTE, por exemplo) e validação cruzada cuidadosa ajudam, mas não substituem volume adequado de dados.
Score sem playbook
Implementar o modelo e publicar o score em um dashboard que ninguém consulta é um desperdício. O investimento em IA para prevenção de churn só gera retorno quando existe um processo claro de quem age, como age e em qual prazo após o gatilho ser disparado. Esse alinhamento entre modelo e operação precisa acontecer antes do go-live, não depois.
Falta de retreinamento periódico
O perfil da base muda com expansão para novos segmentos, lançamento de produto ou crise econômica. Um modelo treinado seis meses atrás com dados de PMEs vai performar mal se a empresa passou a adquirir clientes enterprise. Retreinamento trimestral é um mínimo razoável; monitoramento contínuo de métricas de performance (AUC, precisão, recall) permite detectar degradação antes que ela se torne custosa.
Confundir churn voluntário com involuntário
Churn voluntário (cliente decide cancelar) e churn involuntário (cartão recusado, falha de cobrança) têm causas raiz e soluções completamente diferentes. Misturá-los no dataset de treino produz um modelo que não é bom em prever nenhum dos dois. A separação deve acontecer na etapa de preparação dos dados, antes do treinamento.
Como avaliar maturidade e começar sem infraestrutura avançada
Checklist mínimo de dados
Antes de investir em modelo preditivo, verifique se a empresa consegue responder com dados confiáveis: Qual é a taxa de churn histórica por cohort? Existe log de eventos de uso por cliente? Os dados de suporte estão estruturados e acessíveis? Há pelo menos 12 meses de histórico com volume suficiente de eventos de cancelamento?
Se a resposta for não para mais de dois desses pontos, o esforço imediato deve ser em coleta e estruturação de dados, não em modelagem. Um CDP bem configurado resolve boa parte dessa lacuna ao centralizar eventos de múltiplas fontes em um perfil unificado.
Opções para empresas sem time de dados
Plataformas de CS e CRM com modelos de churn embutidos oferecem ponto de entrada com menor fricção técnica. A contrapartida é menor customização e dependência do vendor para ajustes no modelo. Parceiros especializados em data science permitem modelos sob medida, mas exigem dados organizados e envolvimento interno para contextualizar o negócio.
A escolha depende da maturidade dos dados, do volume da base e da capacidade interna de operacionalizar o output. Em muitos casos, começar com uma ferramenta embutida e migrar para modelo próprio após acúmulo de histórico é o caminho mais pragmático.
Métricas para medir o resultado da iniciativa
Redução absoluta da taxa de churn é a métrica mais direta, mas difícil de atribuir exclusivamente ao modelo sem grupo de controle. Métricas intermediárias mais controláveis incluem: percentual de clientes em risco que receberam intervenção dentro do prazo definido, taxa de conversão das intervenções (cliente retido após contato), custo por retenção (custo da intervenção dividido pelo número de clientes retidos) e LTV protegido, isto é, a receita futura preservada nos clientes que não cancelaram após a ação.
Monitorar essas métricas por cohort de intervenção, separando grupos com e sem ação, é a forma mais rigorosa de quantificar o valor real do modelo.
Próximos passos
Para empresas que estão começando, o caminho mais direto é auditar a qualidade dos dados disponíveis antes de qualquer decisão sobre ferramentas ou metodologia. Sem dados confiáveis de comportamento, transação e suporte, nenhum modelo vai performar bem.
Para quem já tem dados estruturados mas ainda não opera com modelo preditivo, o passo seguinte é definir o playbook de intervenção em paralelo ao desenvolvimento do modelo, não depois. Score sem processo é um projeto incompleto.
Para empresas com modelo em produção, a prioridade é estabelecer rotina de monitoramento de performance e retreinamento periódico. Modelos degradam silenciosamente; a queda na acurácia raramente aparece em dashboards de negócio até que o churn já tenha aumentado de forma perceptível.
Em qualquer estágio, o critério de sucesso não é ter o modelo mais sofisticado: é ter o modelo mais acionável dentro da capacidade operacional existente.