O que é segmentação preditiva com IA
Segmentação tradicional agrupa clientes por critérios definidos manualmente: “mulheres entre 25 e 40 anos que compraram nos últimos 90 dias”. Funciona, mas depende de hipóteses humanas e não captura padrões que o analista ainda não pensou em procurar.
Segmentação preditiva usa modelos estatísticos e de machine learning para identificar padrões latentes no histórico de dados e antecipar comportamentos futuros. O modelo aprende sozinho quais combinações de atributos (frequência de acesso, ticket médio, categoria de produto, canal preferencial) precedem uma compra, um cancelamento ou um aumento de valor.
As saídas mais comuns são três: score de propensão a compra (probabilidade de conversão em determinado período), score de risco de churn (probabilidade de abandono ou cancelamento) e LTV preditivo (estimativa do valor futuro que aquele cliente vai gerar). Cada score vira um atributo que pode alimentar regras de automação, personalização de conteúdo ou priorização de abordagem comercial.
A diferença prática é direta: a segmentação por regra diz quem o cliente foi; a segmentação preditiva diz o que ele provavelmente vai fazer. Isso muda completamente a lógica de intervenção.
Algoritmos e técnicas mais utilizados
Modelos supervisionados
Quando há rótulos históricos — clientes que churnou, clientes que compraram — é possível treinar modelos de classificação. A regressão logística ainda é amplamente usada por ser interpretável e eficiente com volumes médios de dados. O gradient boosting (XGBoost, LightGBM, CatBoost) costuma superar a regressão em acurácia quando há relações não-lineares entre variáveis. Redes neurais entram quando o volume de dados é alto e as interações entre features são complexas demais para árvores de decisão.
A escolha não deve ser guiada apenas pela métrica de validação: interpretabilidade importa. Um modelo que ninguém na empresa consegue explicar para o jurídico ou para o time de negócios vira um risco operacional.
Modelos não supervisionados
Quando não há um rótulo claro para treinar, o clustering descobre grupos sem hipótese prévia. O K-means é o ponto de partida mais comum, mas exige que o número de clusters seja definido a priori e tem dificuldade com grupos de formatos irregulares. O DBSCAN lida melhor com clusters de densidade variável e identifica outliers, o que é útil para detectar clientes de comportamento anômalo que merecem tratamento especial.
Modelos não supervisionados são exploratórios por natureza. O segmento descoberto precisa ser interpretado e validado por analistas de negócio antes de ir para produção.
RFM aumentado com scores preditivos
A análise RFM (Recência, Frequência, Valor) é o ponto de partida de muitas operações de CRM no Brasil. O problema é que ela olha para o passado de forma estática. Uma evolução prática é usar o RFM como conjunto de features de entrada para um modelo preditivo, combinando o histórico comportamental com outras variáveis contextuais para gerar um score dinâmico em vez de uma classificação binária.
Embeddings e similaridade comportamental
Técnicas de embedding, originalmente desenvolvidas para linguagem natural, podem representar cada cliente como um vetor numérico baseado em sua sequência de comportamentos. Com isso, é possível calcular similaridade entre clientes sem definir features manualmente. Clientes com vetores próximos tendem a ter jornadas parecidas, o que abre espaço para recomendação, lookalike e transferência de modelos entre segmentos.
Dados necessários para treinar os modelos
Fontes essenciais
Quatro categorias de dados formam a base de qualquer pipeline preditivo de CRM: histórico transacional (o quê, quando e quanto o cliente comprou), comportamento digital (navegação em site e app, cliques, tempo de sessão), interações com canais (abertura de e-mail, atendimento, ligações, mensagens) e dados cadastrais (localização, segmento, perfil demográfico quando disponível).
Quanto maior a diversidade de fontes, mais rico o perfil, mas também mais complexo o pipeline de integração e limpeza.
Volume e qualidade
Não existe um número universal de registros mínimos, mas modelos supervisionados de churn, por exemplo, precisam de pelo menos alguns milhares de eventos rotulados em cada classe para generalizarem bem. Mais crítico do que o volume é a qualidade: dados duplicados, identidades fragmentadas e atributos com alta taxa de nulidade degradam a acurácia do modelo de forma proporcional.
O papel do CDP
Um Customer Data Platform resolve o problema de identidade antes do pipeline preditivo. Sem unificação de identidade, o mesmo cliente aparece como múltiplos registros, um por canal, um por dispositivo, e o modelo treina em cima de fragmentos, não de pessoas reais. O CDP consolida todos os sinais em um perfil único e persistente, que alimenta os modelos com dados coerentes.
Desafios específicos do mercado brasileiro
O Brasil tem particularidades que complicam o pipeline. A fragmentação de canais é alta: WhatsApp, marketplaces, loja física e e-commerce próprio raramente compartilham dados em tempo real. O CPF funciona como chave de identidade cross-channel mais confiável do que e-mail ou telefone, mas nem sempre está disponível em interações anônimas de topo de funil.
A LGPD exige base legal clara para coleta e processamento de dados pessoais. Modelos preditivos que usam dados sensíveis — localização inferida, comportamento financeiro, histórico de saúde em contextos específicos — precisam de atenção redobrada às categorias especiais da lei e ao princípio da finalidade.
Como aplicar segmentação preditiva em campanhas e jornadas
Ativação nos canais
Um score preditivo só gera valor quando sai do data warehouse e chega à plataforma de execução. Isso exige integração entre o ambiente de modelagem e as ferramentas de automação de marketing, CRM e CDP. Plataformas como Salesforce Marketing Cloud, Adobe Journey Optimizer e Braze já oferecem conectores nativos ou via API para ingestão de scores externos. O segmento preditivo vira, na prática, um atributo de perfil que dispara fluxos ou altera a lógica de personalização.
Personalização dinâmica
Com score de propensão disponível no perfil do cliente, é possível variar dinamicamente o conteúdo de um e-mail, o banner de um app ou a oferta de um agente de atendimento. Clientes com alta propensão a compra recebem ofertas mais diretas e com menor desconto; clientes em risco de churn recebem benefícios de retenção antes de pedirem o cancelamento. Essa lógica de intervenção antecipada é o principal ganho operacional da segmentação preditiva.
Re-treinamento e model drift
Modelos preditivos degradam com o tempo. O comportamento dos clientes muda, novos produtos são lançados, sazonalidades entram em cena. Sem re-treinamento periódico, o score fica desatualizado e as intervenções perdem eficácia. A frequência depende da velocidade de mudança do negócio: varejo de alta frequência pode precisar de re-treinamento mensal; B2B com ciclos longos pode tolerar trimestral. O monitoramento contínuo da distribuição do score (data drift) é o sinal de alerta mais confiável.
Exemplo prático: jornada de retenção com score de churn
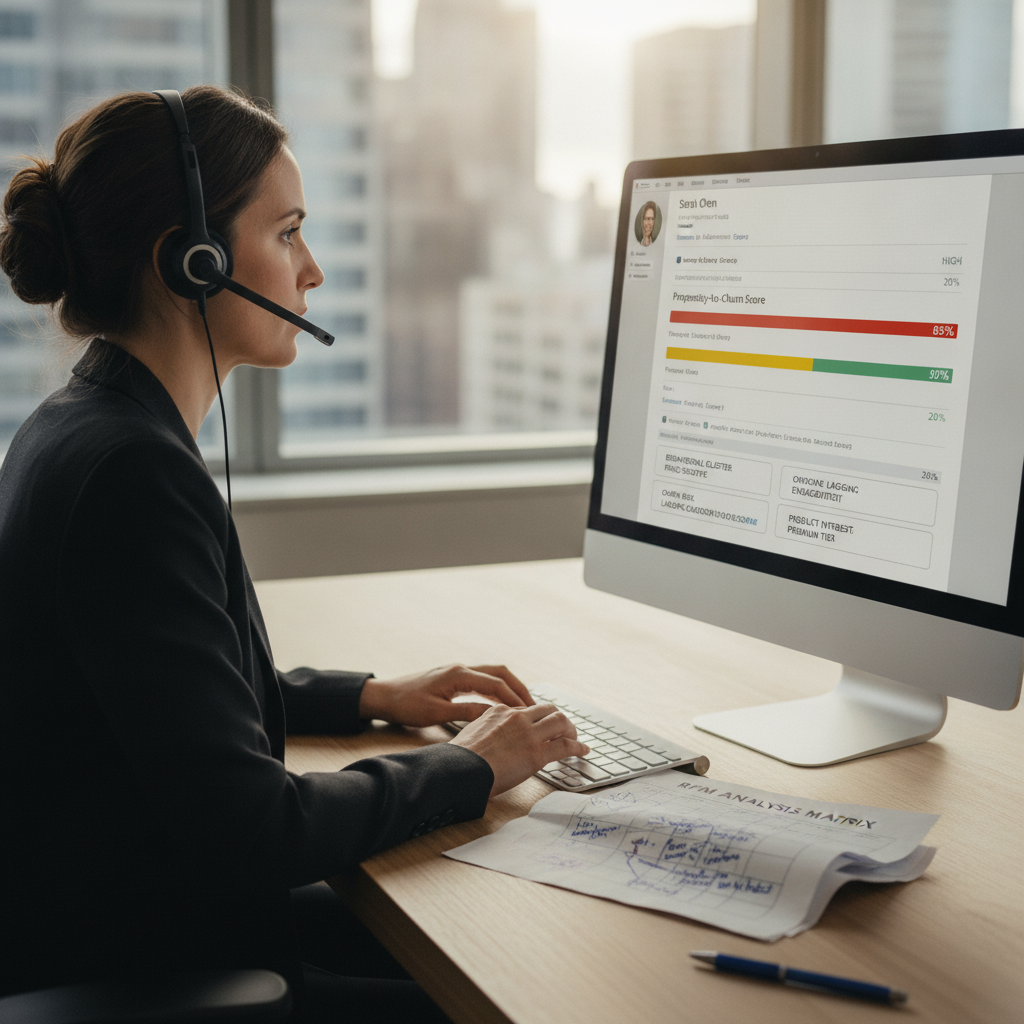
Um operador de telecomunicações ou uma plataforma de assinatura calcula semanalmente o score de risco de churn para toda a base. Clientes que cruzam o limiar de 70% de probabilidade de cancelamento entram automaticamente em uma jornada de retenção: primeiro contato via push com benefício personalizado, depois e-mail com oferta de upgrade, por fim ligação ativa de um agente priorizado pelo CRM. Sem o score, essa jornada seria acionada apenas depois do pedido de cancelamento, quando o custo de reversão é muito maior.
Métricas para avaliar a eficácia dos segmentos
Métricas de modelo
A AUC-ROC mede a capacidade discriminativa do modelo: quanto mais próxima de 1, melhor o modelo separa as classes. Precisão e recall avaliam o equilíbrio entre falsos positivos e falsos negativos. Contextos em que acionar um cliente errado é caro (ligação ativa, desconto desnecessário) exigem alta precisão; contextos em que perder um churner é muito custoso exigem alto recall.
Métricas de modelo são necessárias, mas não suficientes. Um modelo com AUC de 0,85 pode gerar zero impacto de negócio se o segmento identificado já convertia organicamente sem nenhuma intervenção.
Métricas de negócio
As métricas que importam para a operação são: incrementalidade de receita (o quanto a conversão aumentou acima do baseline), redução de churn (variação na taxa de cancelamento do grupo tratado) e custo por conversão comparado ao segmento por regra. Essas métricas conectam o trabalho técnico ao resultado financeiro e justificam o investimento na infraestrutura preditiva.
Teste A/B entre segmentos
A forma mais rigorosa de validar o ganho real é comparar diretamente: parte da base recebe tratamento baseado no segmento preditivo, outra parte recebe o tratamento baseado no segmento por regra tradicional. A diferença nos resultados mede o valor incremental do modelo. Sem esse controle, é impossível distinguir o impacto do modelo do impacto da campanha em si.
Comunicando resultados para não-técnicos
Traduzir AUC e F1-score para um CMO ou VP de Vendas costuma ser um obstáculo. A estratégia mais eficaz é ancorar a explicação em consequências concretas: “o modelo identifica corretamente 8 em cada 10 clientes que vão cancelar nos próximos 30 dias” é mais útil do que “AUC de 0,84”. Visualizações de lift chart e ganho acumulado ajudam a mostrar quanto mais eficiente é o segmento preditivo em relação ao aleatório.
Principais armadilhas e limitações
Viés nos dados de treinamento
Se os dados históricos refletem decisões passadas enviesadas — oferecer crédito apenas para determinado perfil demográfico, por exemplo — o modelo aprende e perpetua esse padrão. O resultado é discriminação algorítmica, com implicações legais e reputacionais. Auditorias de fairness e análise de disparidade entre grupos são práticas obrigatórias antes de colocar qualquer modelo preditivo em produção.
Overfitting
Um modelo que performa muito bem nos dados de treinamento e mal em dados novos está superajustado. Isso acontece quando o modelo aprende ruído específico do conjunto de treino em vez de padrões generalizáveis. Técnicas de regularização, validação cruzada e hold-out temporal (treinar no passado, validar no futuro) são as proteções mais eficazes contra overfitting em contextos de CRM.
Limitações para PMEs brasileiras
Modelos preditivos exigem volume de dados que muitas pequenas e médias empresas brasileiras simplesmente não têm. Uma base de 5.000 clientes com histórico de 12 meses raramente sustenta um modelo de churn confiável. Nesses casos, alternativas mais simples — RFM avançado, regras baseadas em benchmarks setoriais ou modelos pré-treinados por fornecedores de CDP — entregam mais valor com menos risco de modelagem inadequada.
LGPD e base legal para modelos preditivos
O uso de dados pessoais em modelos preditivos precisa de base legal explícita, geralmente legítimo interesse ou execução de contrato, dependendo do contexto. O titular tem direito à explicação sobre decisões automatizadas que o afetem (artigo 20 da LGPD). Modelos de caixa-preta sem capacidade de explicação são problemáticos juridicamente. A adoção de modelos interpretáveis ou técnicas de explicabilidade (SHAP, LIME) não é apenas boa prática técnica: é uma necessidade de conformidade.
Como avaliar se sua operação está pronta
Antes de investir em modelagem preditiva, vale responder honestamente a quatro perguntas:
- Identidade unificada: você consegue reconhecer o mesmo cliente em todos os canais com consistência? Se não, o pipeline de dados precisa vir antes do pipeline de modelos.
- Volume e qualidade: sua base tem histórico transacional suficiente — ao menos 12 a 18 meses — com baixa taxa de nulos e duplicatas? Modelos treinados em dados ruins entregam resultados piores do que regras simples.
- Capacidade de ativação: as plataformas de execução que você usa conseguem consumir scores externos via API ou importação? Um score que fica parado no data warehouse não muda nada.
- Conformidade LGPD: você tem base legal documentada para o uso dos dados no modelo e processo para atender solicitações de explicação por parte do titular?
Se todas as respostas forem positivas, o passo seguinte é definir um caso de uso único — churn, propensão a compra ou LTV — e construir um piloto com um segmento da base, medindo incrementalidade com grupo de controle antes de escalar para a operação inteira.