O que é CX preditivo
CX preditivo é o uso de dados históricos e modelos estatísticos para antecipar necessidades e comportamentos do cliente antes que eles se manifestem. Em vez de reagir a uma reclamação ou ao cancelamento já solicitado, a empresa age com antecedência, porque o modelo indicou que aquele cliente estava a caminho dessa decisão.
Três níveis de análise ajudam a entender o conceito. O CX descritivo responde “o que aconteceu”: relatórios de atendimento, histórico de compras, taxa de churn do último trimestre. O CX preditivo responde “o que vai acontecer”: qual cliente tem maior probabilidade de cancelar nos próximos 30 dias, qual segmento tende a converter com determinada oferta. O CX prescritivo vai além e responde “o que fazer a respeito”: qual ação específica, em qual canal, com qual mensagem.
Essa distinção muda a lógica operacional. O atendimento deixa de ser essencialmente reativo, focado em resolver problemas depois que chegam, e passa a ser proativo: identificar sinais de risco ou oportunidade enquanto ainda há margem de manobra.
No mercado brasileiro, a adoção ainda é desigual. Empresas de telecomunicações, bancos e grandes varejistas já operam com modelos preditivos há alguns anos. Para a maioria das médias empresas, porém, a maturidade de dados ainda está em construção: bases fragmentadas, histórico curto e processos de governança incipientes. Isso não inviabiliza a adoção, mas determina por onde começar.
Como funciona a análise preditiva aplicada à experiência do cliente
Coleta e unificação de dados
Modelos preditivos são tão bons quanto os dados que os alimentam. As fontes mais relevantes para CX incluem histórico de interações (atendimento, chat, e-mail), transações (compras, renovações, devoluções), comportamento digital (navegação, cliques, abandono de carrinho) e sinais de atendimento (tempo de resolução, número de contatos por problema, tom das mensagens).
O problema clássico é que esses dados vivem em sistemas separados. Um cliente pode ter histórico de compra no ERP, reclamação aberta no CRM e comportamento de navegação no analytics, três sistemas que nunca se conversaram. Sem unificação, qualquer modelo preditivo trabalha com uma visão parcial do cliente.
O papel do machine learning
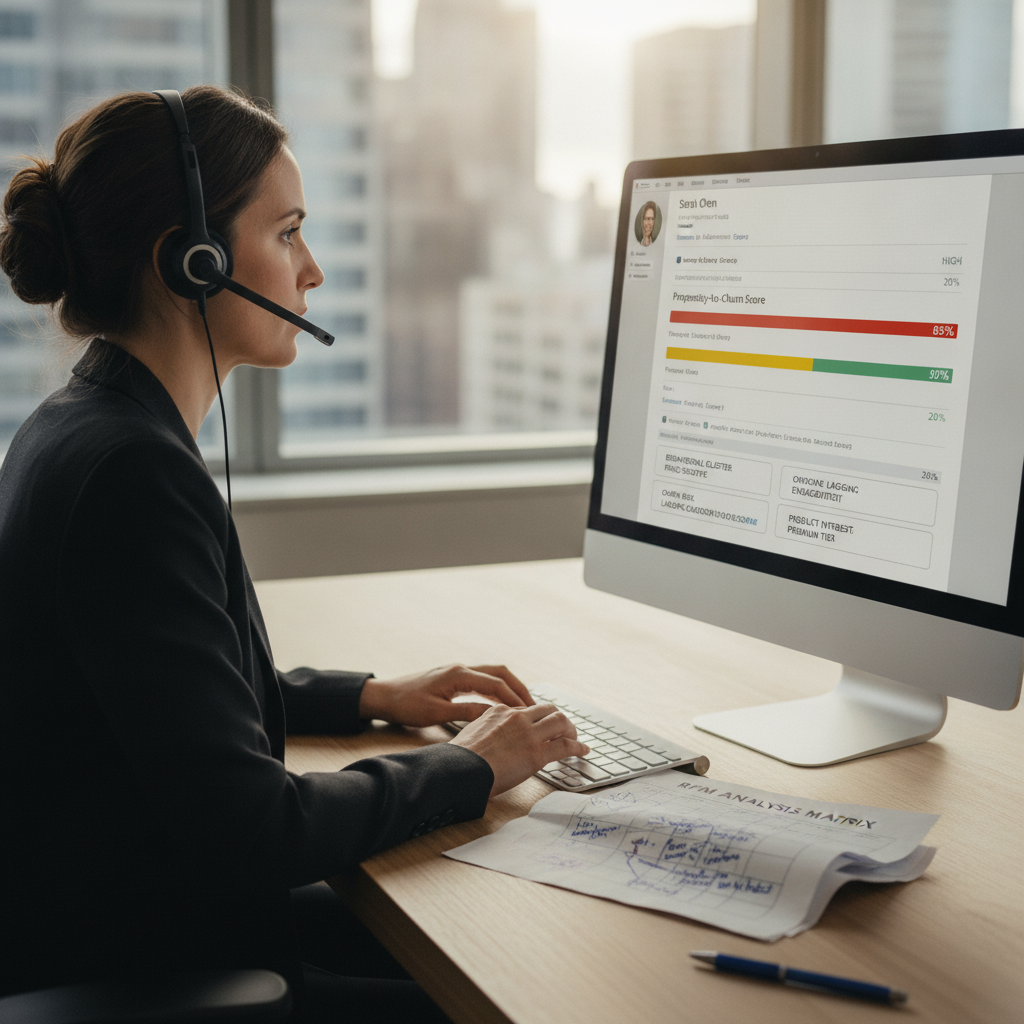
Algoritmos de machine learning identificam padrões que analistas humanos dificilmente detectariam manualmente em bases com milhões de registros. Um modelo de churn, por exemplo, pode descobrir que a combinação de dois contatos ao suporte em menos de dez dias, seguida de inatividade no app por uma semana, é um preditor forte de cancelamento, mesmo que nenhum analista tivesse formulado essa hipótese.
Os principais outputs que esses modelos geram em CX são: score de churn (probabilidade de cancelamento em um período), propensão a compra (likelihood de conversão para um produto específico), risco de insatisfação (probabilidade de o cliente avaliar mal a experiência) e próxima melhor ação (qual intervenção maximiza o resultado esperado para aquele perfil).
O CDP como camada de dados
Uma Customer Data Platform (CDP) atua como a infraestrutura que unifica dados de diferentes fontes e os disponibiliza em tempo real, ou próximo disso, para os modelos preditivos. Sem essa camada, os modelos precisam ser alimentados manualmente ou com extrações periódicas, o que reduz a velocidade de ativação e, consequentemente, o valor prático das previsões.
Principais casos de uso em CX preditivo
Prevenção de churn
É o caso de uso mais difundido. O modelo identifica clientes com alta probabilidade de cancelamento antes do pedido ser feito, e a operação aciona uma intervenção: ligação de retenção, oferta personalizada, contato proativo do gerente de conta. A janela de ação é exatamente o diferencial: agir enquanto o cliente ainda está indeciso, não depois que a decisão foi tomada.
Personalização antecipada
Com base no momento do cliente na jornada e no seu histórico, os modelos recomendam qual produto oferecer, por qual canal abordar e com qual mensagem. Isso vai além da segmentação tradicional: em vez de enviar a mesma campanha para todos os clientes de um segmento, cada cliente recebe a recomendação calculada individualmente para o seu perfil atual.
Gestão de volume de atendimento
Modelos de previsão de demanda permitem antecipar picos de contato, sejam eles causados por sazonalidade, campanhas ou falhas de produto, e alocar recursos com antecedência. Para centrais de atendimento, isso reduz tempo de espera, melhora a experiência e evita horas extras emergenciais. O dado de entrada pode ser histórico de volumes, calendário comercial e sinais externos como feriados e eventos.
Detecção precoce de insatisfação
Cruzar dados de NPS recente, histórico de atendimento e comportamento digital permite identificar clientes que provavelmente estão insatisfeitos antes de uma reclamação formal. Sinais como queda no engajamento, aumento no número de contatos ao suporte e notas baixas em pesquisas intermediárias formam um padrão reconhecível pelos modelos.
Jornadas de reengajamento
Clientes inativos não têm a mesma receptividade ao longo do tempo. Modelos preditivos identificam o momento de maior probabilidade de resposta, com base em comportamento passado, dia da semana e canal preferido, e acionam a comunicação nessa janela. Isso aumenta a taxa de reativação sem necessariamente aumentar o volume de disparos.
Requisitos técnicos e de dados para começar
Volume e qualidade de dados
Não existe um número universal, mas como referência prática: para um modelo de churn confiável, é razoável ter ao menos 12 meses de histórico e volume de eventos suficiente para que o modelo veja tanto clientes que cancelaram quanto os que permaneceram. Bases muito pequenas ou com eventos raros de cancelamento exigem técnicas específicas, como oversampling, e produzem modelos menos generalizáveis.
Qualidade importa tanto quanto volume. Dados com muitos campos nulos, duplicatas de cliente ou inconsistências entre sistemas contaminam o treinamento. Antes de modelar, é necessário um trabalho de limpeza e padronização, etapa frequentemente subestimada em projetos de preditivo.
Infraestrutura de integração
Os modelos precisam de dados frescos para gerar scores atualizados. Isso requer integração entre CRM, plataformas de atendimento, e-commerce e canais digitais, preferencialmente via APIs ou pipelines de dados automatizados, não exportações manuais semanais. A ausência dessa integração é uma das principais razões pelas quais projetos preditivos ficam presos em provas de conceito e não escalam.
Escolha do modelo
Para problemas mais simples e bases menores, regressão logística ainda é uma escolha sólida: interpretável, rápida de treinar e auditável. Para maior precisão em dados complexos, modelos de ensemble como gradient boosting, implementados em bibliotecas como XGBoost e LightGBM, costumam performar melhor, mas exigem mais cuidado na validação e são menos transparentes. A escolha deve considerar também quem vai manter o modelo no dia a dia.
Governança e LGPD
Modelagem preditiva usa dados pessoais de forma intensiva. A LGPD exige base legal adequada para o tratamento, e o uso de dados para decisões automatizadas que afetam o titular requer atenção especial ao artigo 20 da lei, que garante ao consumidor o direito de solicitar revisão humana. Mapear quais dados entram nos modelos, com qual finalidade e por quanto tempo são retidos é parte da conformidade, não um detalhe posterior.
Limitações e armadilhas comuns
Viés nos dados de treinamento
Modelos aprendem com o passado. Se a base histórica reflete distorções, por exemplo um processo de atendimento que priorizava determinado perfil de cliente, o modelo vai reproduzir e escalar esse viés. Auditar a base de treinamento em busca de desequilíbrios por segmento, região ou canal é uma etapa que muitos projetos pulam e depois pagam caro.
Superestimar a precisão dos modelos
Um score de churn de 80% não significa que o cliente vai cancelar com certeza: significa que, em perfis similares, 80% cancelaram. Os 20% restantes que não cancelariam receberão uma intervenção desnecessária, com custo operacional real. Calibrar o threshold do modelo com base no custo de cada tipo de erro (falso positivo versus falso negativo) é fundamental antes de colocar qualquer modelo em produção.
Prever sem acionar
O erro mais comum em projetos preditivos não é técnico, é operacional. O modelo gera os scores, o relatório é enviado e ninguém age a tempo porque o processo de ativação não foi definido. Predição sem fluxo de resposta integrado às equipes de atendimento, retenção ou marketing não gera resultado. O design do processo operacional precisa acontecer em paralelo ao desenvolvimento do modelo, não depois.
Modelos desatualizados
O comportamento do consumidor muda, especialmente após crises econômicas, mudanças regulatórias ou alterações no produto. Um modelo treinado com dados de dois anos atrás pode ter performance muito degradada no presente. Definir uma cadência de retreinamento e monitorar o desempenho do modelo em produção, o que a literatura chama de concept drift, é parte da operação contínua, não da fase de projeto.
Como avaliar se sua empresa está pronta para CX preditivo
Checklist de maturidade
Antes de investir em modelagem preditiva, vale verificar: os dados de clientes estão unificados em uma visão única, ou cada sistema tem seu próprio identificador? Existe histórico de ao menos 12 meses de interações e transações? Os processos de ativação, ou seja, quem age, com qual abordagem e em qual prazo, já estão definidos? Se a resposta for “não” para dois ou mais desses pontos, o projeto vai travar na implementação, não na modelagem.
Começar pequeno
A melhor estratégia de adoção é escolher um caso de uso com ROI claro e escopo delimitado. Redução de churn em uma linha de produto, reengajamento de clientes inativos em um canal específico ou previsão de volume de atendimento em uma região: qualquer um desses é preferível a tentar construir uma plataforma preditiva completa de uma só vez. O caso pequeno prova o valor, gera aprendizado interno e cria o argumento para escalar.
Métricas de desempenho
Acompanhar apenas a acurácia do modelo é insuficiente. Em problemas com classes desbalanceadas, como churn, onde cancelamentos são minoria, a acurácia pode ser alta mesmo com um modelo inútil. Métricas mais relevantes são precisão (dos que o modelo sinalizou, quantos realmente cancelaram), recall (dos que cancelaram, quantos o modelo identificou) e, acima de tudo, o impacto nos indicadores de negócio: taxa de retenção, CSAT e receita salva.
Construir internamente ou contratar solução de mercado
Construir internamente faz sentido quando a empresa tem equipe de data science estruturada, casos de uso altamente específicos do negócio e capacidade de manter os modelos no longo prazo. Contratar uma solução de mercado, e existem plataformas especializadas em preditivo para CX, além de funcionalidades nativas em CDPs e CRMs mais maduros, é mais adequado quando a prioridade é velocidade de implementação e o caso de uso é suficientemente genérico para ser atendido por modelos pré-construídos. A decisão não é binária: muitas empresas usam modelos proprietários para os casos centrais e soluções de mercado para os periféricos.