O que é um data pipeline para marketing
Um data pipeline é um fluxo automatizado que coleta dados brutos de múltiplas fontes, transforma esses dados em um formato utilizável e os entrega a um destino final: um banco de dados, uma ferramenta de BI ou uma plataforma de ativação. O processo elimina o trabalho manual de mover e formatar dados entre sistemas.
A diferença entre um pipeline genérico e um pipeline orientado a marketing está no contexto dos dados e nas integrações necessárias. Um pipeline de marketing precisa lidar com fontes como plataformas de mídia paga, CRMs, ferramentas de e-mail, plataformas de e-commerce e sistemas de analytics, cada uma com sua própria estrutura, frequência de atualização e formato de saída.
O papel central desse pipeline é a centralização. Equipes de marketing raramente operam com uma única fonte de verdade: os dados de aquisição ficam no Google Ads ou no Meta, os dados de comportamento no site ficam no GA4 ou no Amplitude, os dados de clientes ficam no CRM, e as transações ficam no e-commerce. Sem um pipeline, a única alternativa é exportar planilhas manualmente e cruzar tudo na mão, processo lento, propenso a erros e inescalável.
Como um data pipeline para marketing funciona na prática
Ingestão: captura dos dados brutos
A primeira etapa é a ingestão, onde os dados são capturados diretamente das fontes originais. Isso pode acontecer via APIs (como a API do Google Ads ou do Meta Ads), webhooks, conectores nativos de plataformas de ETL ou agentes de coleta instalados diretamente nos sistemas de origem.
Nessa fase, os dados chegam no estado bruto, com inconsistências, campos nulos, formatos variados e duplicidades. O pipeline garante que esses dados sejam capturados de forma confiável e armazenados em uma área intermediária, geralmente chamada de staging area ou camada de dados brutos (raw layer).
Transformação: limpeza, padronização e enriquecimento
A etapa de transformação é onde o valor real começa a aparecer. Os dados brutos são limpos (remoção de duplicatas, tratamento de nulos), padronizados (formatos de data, moedas, nomenclaturas de canais) e enriquecidos (combinação com outras fontes, adição de atributos calculados como LTV ou custo por aquisição).
Em pipelines modernos, essa transformação acontece frequentemente dentro do próprio data warehouse usando ferramentas como dbt (data build tool), que permitem versionar as transformações como código. Isso traz rastreabilidade e facilita auditorias, algo especialmente relevante em contextos onde a conformidade com a LGPD precisa ser documentada.
Carregamento: entrega ao destino final
Após a transformação, os dados são carregados no destino final. Dependendo da arquitetura adotada, esse destino pode ser um data warehouse como BigQuery, Snowflake ou Redshift, um CDP, uma ferramenta de BI como Looker, Metabase ou Power BI, ou diretamente uma plataforma de automação de marketing.
O padrão mais comum hoje é o modelo ELT (Extract, Load, Transform), onde os dados são carregados primeiro no warehouse e transformados depois, ao contrário do ETL tradicional, onde a transformação precede o carregamento. O ELT aproveita a capacidade de processamento dos warehouses modernos e oferece mais flexibilidade para reusar os dados em diferentes casos de uso.
Batch versus streaming: quando cada abordagem faz sentido
Pipelines em batch processam dados em lotes em intervalos definidos: a cada hora, uma vez por dia, uma vez por semana. Para a maioria dos casos de marketing, como relatórios de performance de campanhas ou atualização de dashboards de ROI, o processamento em batch é suficiente e mais simples de manter.
Pipelines em streaming processam dados em tempo real ou quase real, conforme os eventos acontecem. Isso faz sentido quando a latência importa: personalização em tempo real no site, acionamento de comunicações baseadas em comportamento imediato ou detecção de anomalias em campanhas ativas. Streaming exige infraestrutura mais complexa e custos operacionais maiores. A decisão entre as duas abordagens deve partir da real necessidade do negócio, não de tendência tecnológica.
Principais casos de uso em equipes de marketing
Consolidação de métricas de mídia paga
Reunir dados de Google Ads, Meta Ads, TikTok Ads, LinkedIn Ads e outras plataformas em um único painel é um dos casos de uso mais imediatos e com retorno rápido. Sem um pipeline, o analista passa horas exportando relatórios de cada plataforma e consolidando em planilhas. Com um pipeline, esses dados chegam automaticamente ao warehouse e ficam disponíveis para visualização em qualquer ferramenta de BI conectada.
O ganho não é apenas de tempo: a padronização das métricas entre plataformas, que usam definições diferentes para “clique”, “impressão” ou “conversão”, acontece de forma consistente e auditável, sem depender do critério individual de quem exportou o dado.
Alimentação de modelos de atribuição
Modelos de atribuição precisam de dados unificados de toda a jornada do cliente: impressões de mídia, cliques, visitas ao site, interações com e-mail, contatos com o suporte e, finalmente, a conversão. Esse cruzamento só é possível quando todos esses dados passam por um pipeline que os unifica em torno de um identificador comum, geralmente o e-mail ou um ID de cliente.
Sem o pipeline, qualquer modelo de atribuição fica limitado ao que cada plataforma enxerga isoladamente, o que inevitavelmente superestima o papel do último clique e subestima canais de topo de funil.
Sincronização de segmentos entre sistemas
Equipes de marketing frequentemente precisam usar o mesmo segmento de audiência em múltiplos sistemas: uma lista de clientes em risco de churn precisa estar no CRM para abordagem do time de sucesso, na plataforma de e-mail para uma campanha de retenção e no Meta para exclusão de anúncios de aquisição. O pipeline automatiza essa sincronização, garantindo que os segmentos estejam atualizados em todos os pontos de ativação simultaneamente.
Relatórios de ROI sem exportação manual
A atualização automática de relatórios de ROI elimina um dos maiores gargalos operacionais em equipes de marketing: o ciclo de “me manda os dados atualizados”. Com um pipeline funcionando, os dados de custo das plataformas de mídia, as receitas do e-commerce e os dados intermediários de pipeline de vendas do CRM chegam ao warehouse de forma contínua e ficam disponíveis nos relatórios sem intervenção humana.
Desafios comuns na implementação no contexto brasileiro
Fragmentação com plataformas locais
O mercado brasileiro tem um conjunto de plataformas de gestão que não têm conectores nativos na maioria das ferramentas internacionais de ETL. Sistemas como VTEX, Linx, Bling, Omie ou TOTVS frequentemente exigem desenvolvimento de conectores customizados ou uso de APIs com documentação limitada. Isso eleva o custo e o tempo de implementação em relação ao que seria esperado em um ambiente com plataformas globais padronizadas.
Antes de escolher uma ferramenta de pipeline, mapear todas as fontes de dados relevantes e verificar quais têm conectores nativos e quais exigirão desenvolvimento adicional é um passo que não pode ser pulado. Esse levantamento costuma revelar surpresas, especialmente quando o ERP ou o sistema de ponto de venda é uma plataforma regional pouco documentada.
Conformidade com a LGPD
Um data pipeline movimenta dados pessoais entre sistemas, e cada etapa desse fluxo precisa estar documentada e em conformidade com a LGPD. Isso envolve definir qual é a base legal para o tratamento em cada etapa, garantir que dados de titulares que solicitaram exclusão sejam removidos de toda a cadeia do pipeline, e documentar os fluxos de dados para fins de relatório de impacto à proteção de dados (RIPD).
Pipelines mal projetados tendem a replicar dados pessoais em múltiplas camadas sem controle de acesso adequado, criando riscos regulatórios além dos técnicos. A governança de dados precisa ser pensada desde o desenho da arquitetura, não adicionada depois.
Maturidade técnica das equipes de marketing
A maioria das equipes de marketing no Brasil não tem capacidade técnica para operar ou monitorar um pipeline de dados de forma autônoma. Isso cria uma dependência estrutural do time de engenharia ou do fornecedor que implementou a solução. Quando algo quebra, e vai quebrar, o time de marketing fica cego até que o time técnico resolva.
Uma forma de mitigar esse problema é investir em ferramentas que ofereçam observabilidade acessível: alertas automáticos quando uma fonte para de enviar dados, logs de erros em linguagem compreensível e dashboards de saúde do pipeline que o próprio analista de marketing consiga interpretar.
Dependência de engenharia de dados
Mesmo com ferramentas no-code ou low-code, há uma tendência de que o pipeline se torne um gargalo gerenciado pelo time de engenharia. Toda nova fonte de dados, toda mudança de schema, toda correção de transformação vira um ticket em uma fila que pode levar dias ou semanas para ser atendido.
Reduzir esse gargalo exige uma combinação de escolha de ferramentas adequadas (algumas plataformas modernas de ETL permitem que analistas gerenciem conectores sem código), processos bem definidos de ownership dos dados e investimento em capacitação técnica básica para profissionais de marketing e analytics.
Critérios para escolher a abordagem certa
Volume e frequência dos dados
Para equipes com poucas fontes de dados, volumes moderados e necessidade de atualização diária, uma solução simples de ETL com conectores prontos resolve o problema sem over-engineering. Não é necessário construir uma infraestrutura complexa de streaming para alimentar um relatório consultado uma vez por dia.
O volume e a frequência determinam também a escolha do destino: para volumes pequenos, até um banco de dados relacional simples pode ser suficiente. Para grandes volumes com consultas analíticas complexas, um data warehouse colunar faz mais sentido.
Customização versus conectores prontos
Ferramentas como Fivetran, Airbyte e Stitch oferecem centenas de conectores prontos para as principais plataformas de marketing e e-commerce. Para equipes sem recursos de engenharia dedicados, essas soluções gerenciadas eliminam a necessidade de manter código de integração. A desvantagem é o custo, que pode ser significativo em volumes altos, e a dependência do roadmap do fornecedor para novos conectores.
Quando as fontes de dados incluem sistemas customizados ou plataformas regionais sem conector disponível, a construção de integrações próprias usando frameworks como Apache Airflow ou Prefect pode ser inevitável. Nesses casos, o custo de desenvolvimento precisa ser considerado no TCO total da solução.
Custo total de operação
Ferramentas gerenciadas eliminam o custo de infraestrutura e manutenção, mas cobram por volume de dados ou número de conectores. Soluções self-hosted exigem time técnico para manter, mas podem ser mais econômicas em escala. A comparação precisa incluir não apenas o custo da ferramenta, mas o custo do tempo de engenharia para configurar, manter e evoluir o pipeline.
Escalabilidade
Um bom pipeline precisa absorver novas fontes de dados sem exigir reescrita da arquitetura. Antes de fechar com qualquer abordagem, vale simular: “se amanhã precisarmos adicionar dados do TikTok Ads, de um novo ERP e de um sistema de suporte, o que precisaria mudar?” A resposta a essa pergunta revela o nível real de escalabilidade da solução.
Relação entre data pipeline, CDP e stack de marketing
O data pipeline e o CDP são componentes complementares, não substitutos. O pipeline é a infraestrutura que move e transforma dados entre sistemas. O CDP é a plataforma que unifica dados de clientes, cria perfis consolidados e os disponibiliza para segmentação e ativação. O pipeline alimenta o CDP, e frequentemente alimenta outros destinos ao mesmo tempo.
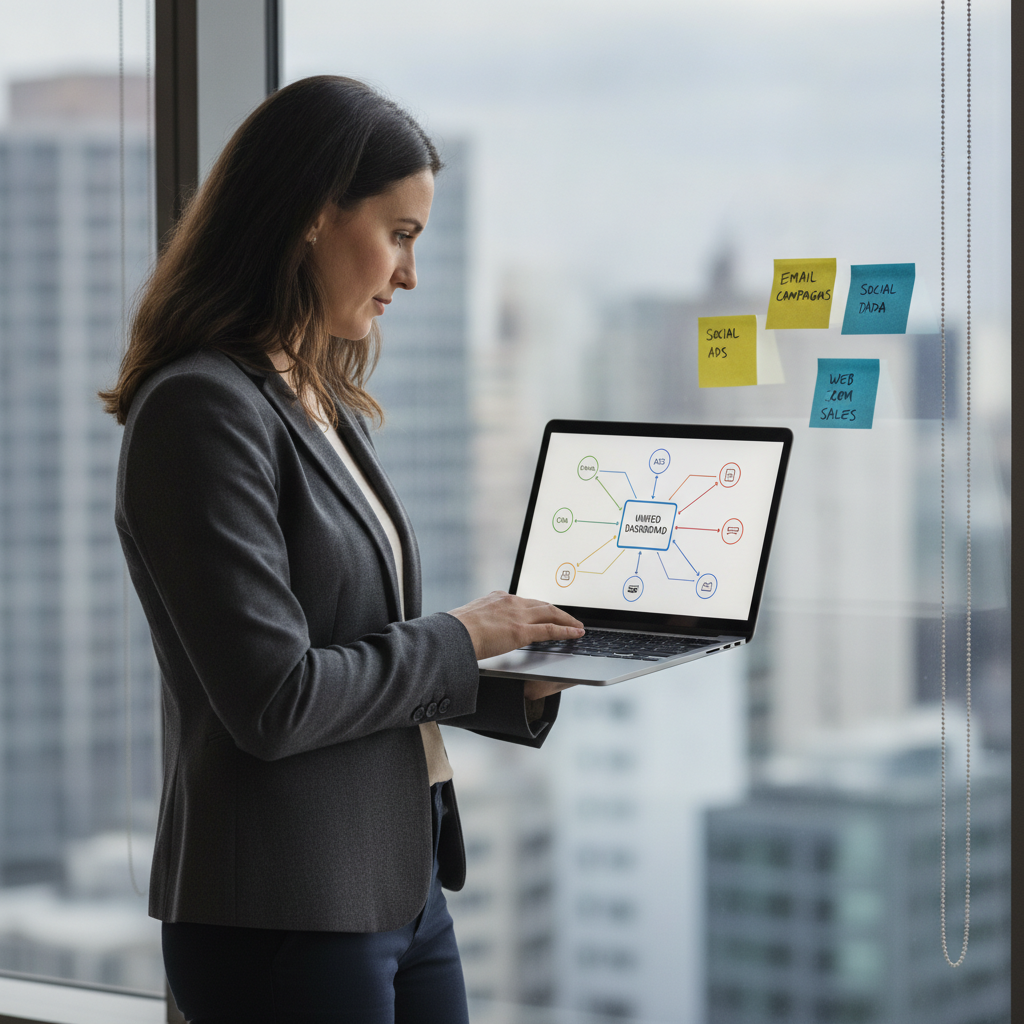
Na arquitetura moderna de marketing data stack, o pipeline ocupa uma posição central: conecta as fontes de dados (plataformas de mídia, e-commerce, CRM, sistemas offline) ao layer de armazenamento (data warehouse) e dali distribui os dados para as ferramentas de consumo (CDP, BI, plataformas de automação). Remover o pipeline significa voltar a depender de integrações ponto a ponto, difíceis de manter e impossíveis de auditar em escala.
CDPs modernos como Segment, mParticle e RudderStack têm capacidades de ingestão e roteamento de dados que se sobrepõem parcialmente às funções de um pipeline. Mas essa sobreposição raramente cobre todos os casos de uso: dados históricos de sistemas legados, integrações com ERPs ou sincronização com data warehouses para análises avançadas geralmente ainda exigem um pipeline independente.
Construir o pipeline antes de adotar um CDP faz sentido quando a equipe ainda não tem clareza sobre quais dados existem e em que estado estão. Implementar um CDP sem dados limpos e unificados é um caminho certo para um projeto que entrega menos do que prometeu. O pipeline força a organização a resolver problemas básicos de qualidade e governança de dados, trabalho que vai ser necessário de qualquer forma, com ou sem CDP.
Como avaliar se sua equipe está pronta para um data pipeline
Antes de iniciar qualquer implementação, responda às perguntas abaixo. Elas ajudam a calibrar a complexidade adequada da solução e a identificar os maiores riscos do projeto.
- Quais são todas as fontes de dados relevantes para marketing? Liste cada sistema que gera dados usados em decisões de campanha, atribuição ou relatórios. Identifique quais têm API disponível e quais exigem exportação manual.
- Existe um identificador comum entre as fontes? Sem um ID de cliente consistente (e-mail, CPF hasheado, ID interno), a unificação de dados fica comprometida desde o início.
- Quem vai ser o dono do pipeline? Defina claramente se a responsabilidade é do time de dados, do time de marketing ou de um fornecedor externo, e quem aciona quem quando algo quebra.
- Os dados coletados estão cobertos pela base legal adequada na LGPD? Consulte o DPO ou responsável pela privacidade antes de incluir dados pessoais no pipeline.
- Qual é o caso de uso prioritário? Comece com um único problema bem definido, como consolidar métricas de mídia paga, antes de escalar para casos mais complexos. Pipelines que tentam resolver tudo ao mesmo tempo tendem a não resolver nada direito.
- A ferramenta escolhida tem conector para suas fontes locais? Verifique o catálogo de conectores antes de assinar qualquer contrato. Um conector faltando pode dobrar o tempo e o custo de implementação.
Responder a essas perguntas com honestidade, envolvendo as áreas de dados, tecnologia e jurídico desde o início, aumenta substancialmente a chance de um projeto de data pipeline que entregue valor real para o marketing, sem virar mais um projeto inacabado na fila do backlog de engenharia.