Por que a ética em IA virou prioridade para quem trabalha com dados de clientes
CRMs, CDPs e canais digitais acumulam volumes de dados de clientes em escala que seria impensável há uma década. Cada interação, clique, compra, chamado de suporte ou resposta a e-mail alimenta modelos que decidem preços, prioridades de atendimento e ofertas personalizadas. Quanto maior o volume e a granularidade, maior o potencial de uso indevido, intencional ou não.
Pesquisas de comportamento do consumidor brasileiro mostram que a preocupação com privacidade cresceu de forma consistente desde a entrada em vigor da LGPD. Clientes percebem quando uma recomendação é “estranha demais” ou quando uma oferta parece ter chegado cedo demais para ser coincidência. Essa percepção afeta confiança e, consequentemente, retenção.
Falhas éticas não são riscos abstratos. Empresas já foram multadas pelo uso indevido de dados, sofreram boicotes públicos e perderam contratos B2B após auditorias de fornecedores que exigiam compliance ético. O dano reputacional costuma chegar antes da sanção regulatória e é mais difícil de reverter.
A LGPD estabelece um piso mínimo legal. Conformidade legal e comportamento ético, porém, não são sinônimos. Uma empresa pode estar dentro da lei e ainda assim usar dados de formas que prejudicam clientes vulneráveis, reproduzem discriminação ou violam expectativas razoáveis de privacidade. Tratar a LGPD como teto de responsabilidade é um erro estratégico.
Principais dilemas éticos no uso de IA com dados de clientes
Personalização versus intrusão
Personalização eficaz exige dados. Privacidade exige contenção na coleta. Esse conflito não tem solução perfeita, apenas calibragem consciente. O problema ocorre quando a lógica de “coletar tudo que for possível” prevalece sem questionamento sobre o que é realmente necessário para entregar valor ao cliente.
A coleta extensiva cria superfícies de risco desproporcionais ao benefício gerado. Dados coletados sem finalidade clara hoje podem ser usados de formas não previstas amanhã, especialmente quando os modelos evoluem ou a empresa é adquirida.
Vieses algorítmicos
Modelos treinados com dados históricos herdam os preconceitos embutidos nesses dados. Se o histórico de crédito de uma empresa reflete práticas discriminatórias passadas, como menor aprovação para determinados CEPs ou perfis demográficos, o modelo vai reproduzir e até amplificar esse padrão.
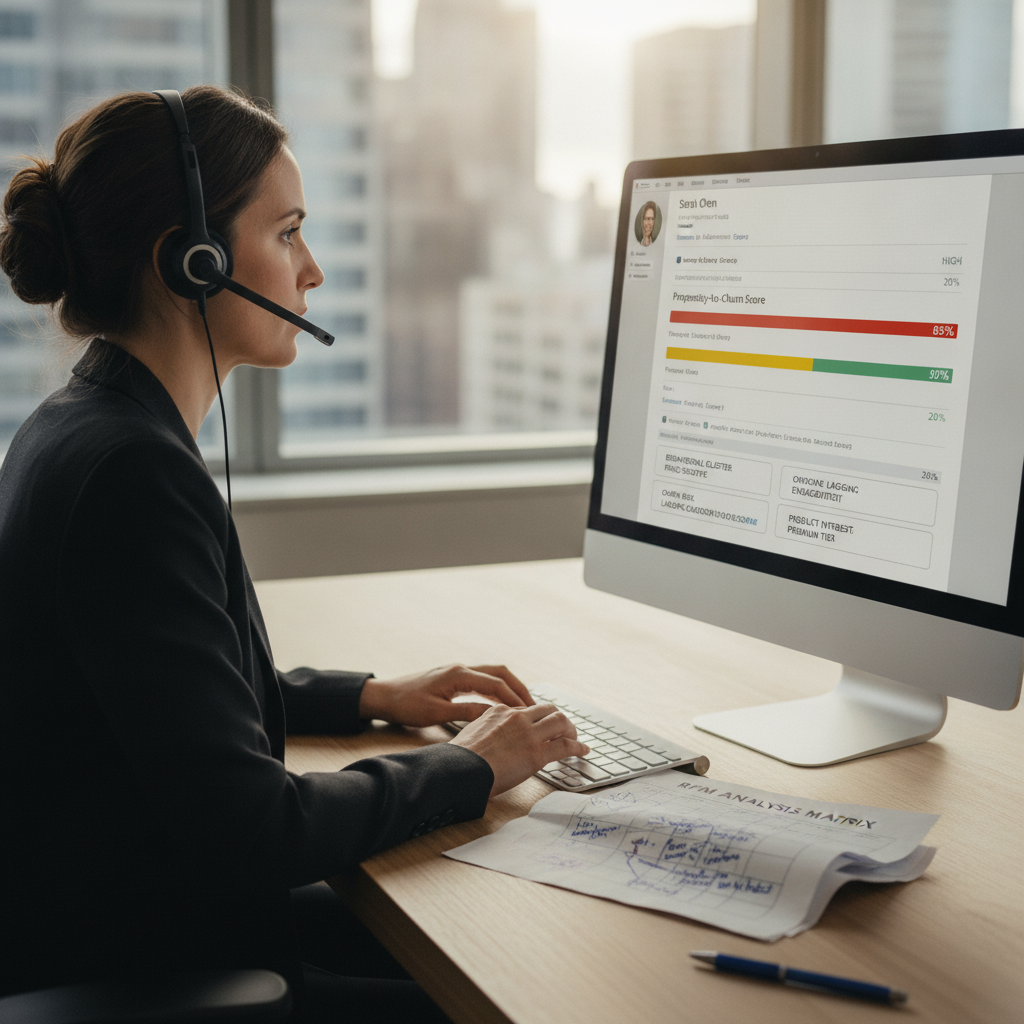
Isso afeta não só crédito. Segmentações de marketing, filas de atendimento prioritário e scores de churn podem todos carregar vieses que prejudicam grupos específicos de clientes sem que ninguém na operação perceba ou questione.
Opacidade dos modelos
Modelos de gradient boosting, redes neurais profundas e LLMs aplicados a dados de clientes frequentemente operam como caixas-pretas. A empresa sabe o que entra e o que sai, mas não consegue explicar o caminho. Isso é problemático quando a saída é uma decisão que afeta o cliente: negar um benefício, escalar ou não um atendimento, oferecer ou não uma condição comercial.
Consentimento real versus consentimento formal
Aceitar um termo de uso não significa compreender o que está sendo autorizado. Termos longos, linguagem técnica e caixas de seleção pré-marcadas criam conformidade legal sem consentimento genuíno. O cliente que “concordou” com o uso de seus dados para treinar modelos de IA raramente sabia o que isso significava na prática.
Uso secundário de dados
Dados coletados para uma finalidade, como completar uma compra ou responder um chamado, são frequentemente reutilizados para treinar modelos com objetivos diferentes. Isso viola o princípio da finalidade da LGPD e, mais amplamente, a expectativa razoável do cliente sobre como seus dados serão usados.
IA explicável e governança de dados: como reduzir a caixa-preta
O que é IA explicável e por que ela importa
IA explicável (XAI, do inglês Explainable AI) é um conjunto de técnicas e práticas que tornam compreensível por que um modelo chegou a determinada saída. Em contextos de relacionamento com o cliente, isso significa conseguir responder: “por que esse cliente recebeu essa oferta e não aquela?” ou “por que o score de risco desse cliente é X?”
Ferramentas como SHAP (SHapley Additive exPlanations) e LIME (Local Interpretable Model-agnostic Explanations) ajudam a identificar quais variáveis mais influenciaram uma decisão específica. Elas não eliminam a complexidade dos modelos, mas tornam as decisões auditáveis.
Documentação de modelos
Todo modelo em produção que afeta clientes deve ter documentação mínima: quais dados foram usados no treinamento, qual a janela temporal desses dados, quais critérios definem as saídas e quem aprovou o modelo para uso. Sem isso, é impossível auditar, corrigir ou contestar decisões.
Model cards, formato de documentação popularizado pelo Google mas adotável de forma independente, são um ponto de partida prático. O importante é que a documentação exista, seja atualizada e seja acessível a quem precisa tomar decisões sobre o modelo.
Auditorias periódicas
Modelos degradam. O comportamento do cliente muda, o mercado muda, os dados de entrada mudam. Um modelo justo no lançamento pode desenvolver viés ao longo do tempo por deriva dos dados. Auditorias periódicas, trimestrais ou semestrais dependendo do volume e criticidade, são necessárias para identificar essa degradação antes que ela cause dano.
Data steward e comitê de ética de dados
Governança ética de IA não vive apenas em políticas escritas. Ela precisa de pessoas com responsabilidade explícita. O papel do data steward é zelar pela qualidade, uso adequado e conformidade dos dados no dia a dia. Um comitê de ética de dados, com representantes de jurídico, tecnologia, negócios e, quando possível, clientes ou consumidores, avalia casos limítrofes e define precedentes internos.
Boas práticas para uso ético de IA em CRM e CDP
Minimização de dados
Coletar apenas o que é necessário para a finalidade declarada reduz risco e simplifica governança. A pergunta que deve anteceder qualquer coleta é: “se não tivermos esse dado, o que não conseguiremos fazer?” Se a resposta for “nada crítico”, o dado provavelmente não precisa ser coletado.
Anonimização e pseudonimização
Antes de alimentar pipelines de treinamento, dados pessoais devem ser anonimizados ou pseudonimizados. A distinção importa: dados verdadeiramente anonimizados saem do escopo da LGPD; dados pseudonimizados ainda são pessoais, mas com camada adicional de proteção. Nenhuma das duas técnicas é trivial de implementar bem, já que a anonimização feita de forma inadequada pode ser revertida por linkage attacks.
Mecanismos reais de opt-out e portabilidade
Botões de opt-out que não funcionam, formulários que exigem múltiplos passos para cancelar uma preferência ou respostas a pedidos de portabilidade fora do prazo legal são problemas técnicos com implicações éticas e regulatórias. O teste prático é simples: peça a alguém externo para exercer um direito e meça o que acontece.
Testes de equidade antes de ir para produção
Fairness testing avalia se o modelo performa de forma consistente entre grupos demográficos diferentes, como gênero, faixa etária, localização geográfica e renda estimada. Métricas como paridade demográfica, igualdade de oportunidade e calibração por grupo devem ser verificadas antes do lançamento e monitoradas em produção.
Transparência ativa com o cliente
Quando uma decisão relevante foi tomada por um sistema automatizado, seja negar um upgrade, priorizar ou desprioritizar um atendimento ou definir um preço personalizado, o cliente tem o direito de saber. Isso não significa expor o modelo, mas informar que houve automação e oferecer um caminho de contestação.
Armadilhas comuns que empresas brasileiras cometem ao adotar IA com dados de clientes
Tratar LGPD como equivalente a ética. Conformidade legal é condição necessária, não suficiente. Uma empresa pode estar em conformidade com a LGPD e ainda usar dados de formas que prejudicam clientes de maneira sistêmica. A lei define o que é proibido; a ética define o que é certo.
Delegar responsabilidade ética ao fornecedor. Contratar uma plataforma de IA ou um CDP não transfere responsabilidade sobre o uso dos dados. O contrato com o fornecedor precisa especificar obrigações éticas, não apenas técnicas. SLAs que incluam auditabilidade, gestão de viés e transparência de modelos são necessários, não opcionais.
Ignorar dados históricos contaminados. Treinar modelos com dados de períodos em que a empresa praticava ou tolerava discriminação reproduz essas práticas em escala automatizada. Antes de usar dados históricos para treinamento, é necessário avaliar se eles refletem o comportamento que se quer incentivar.
Lançar IA sem comunicar os clientes. Implementar scoring de churn, atendimento priorizado por IA ou personalização algorítmica sem informar os clientes cria assimetria de informação que corrói confiança quando, não se, vier à tona. Transparência proativa é menos custosa do que gestão de crise reativa.
Como estruturar uma política interna de ética em IA orientada a dados de clientes
Mapear e classificar casos de uso por risco
O primeiro passo é inventariar todos os casos de uso de IA que envolvem dados pessoais de clientes. Em seguida, classifique cada um por nível de risco: baixo (recomendações de conteúdo sem consequências diretas), médio (segmentação para ofertas comerciais) e alto (decisões de crédito, priorização de atendimento, precificação dinâmica).
Casos de alto risco exigem revisão ética explícita antes do lançamento e monitoramento contínuo em produção. Casos de baixo risco podem seguir um processo simplificado. A classificação deve ser revisada se o escopo do modelo mudar.
Definir princípios não negociáveis
A política deve estabelecer princípios que se aplicam independentemente de contexto ou pressão comercial: equidade no tratamento entre grupos de clientes, transparência sobre automação, responsabilização clara por decisões de modelos e minimização de dados como padrão, não exceção.
Princípios sem mecanismos de enforcement são decorativos. Cada princípio deve ter um critério verificável associado, com definição de como é medido, quem verifica e com qual frequência.
Criar processo de revisão ética pré-lançamento
Antes de colocar um modelo em produção que afete clientes, deve haver uma etapa formal de revisão ética. Isso inclui verificação de fairness, revisão da documentação do modelo, análise de riscos de uso indevido e aprovação por uma instância com autoridade para barrar o lançamento se necessário.
Esse processo não precisa ser burocrático a ponto de travar a inovação. Para casos de risco baixo, pode ser uma checklist de 10 itens revisada em 30 minutos. Para casos de risco alto, uma reunião do comitê com representação multidisciplinar.
Estabelecer canal de contestação para clientes
Clientes afetados por decisões automatizadas, especialmente decisões negativas, devem ter um canal claro para contestar e obter revisão humana. Esse canal precisa funcionar na prática: prazo de resposta definido, responsável identificado e capacidade de reverter a decisão quando a contestação for válida.
Revisão contínua
Ética em IA não é um projeto com entrega final. Modelos mudam, dados mudam, o contexto social e regulatório muda. A política precisa de revisão periódica, anual no mínimo, e de gatilhos para revisão extraordinária: mudança significativa no volume de dados, expansão para novos casos de uso, incidente com cliente ou atualização regulatória relevante.
Como avaliar a maturidade ética da sua operação com IA
Use as perguntas abaixo como diagnóstico interno. Não há pontuação, o objetivo é identificar lacunas concretas para endereçar:
- Você consegue listar todos os modelos de IA em produção que tomam ou influenciam decisões sobre clientes?
- Cada um desses modelos tem documentação atualizada sobre dados de treinamento e critérios de saída?
- Algum deles passou por fairness testing antes de ir para produção? Os resultados foram documentados?
- Os clientes são informados quando uma decisão relevante foi tomada por automação?
- Existe um canal funcional para contestação de decisões automatizadas? Foi testado recentemente?
- Os contratos com fornecedores de IA e CDP incluem obrigações éticas explícitas, além das técnicas?
- Há uma instância interna com autoridade para barrar o lançamento de um modelo por razões éticas?
- Os dados históricos usados para treinamento foram avaliados quanto a vieses discriminatórios?
Lacunas identificadas nesse diagnóstico são o ponto de partida para um roadmap de governança ética. A prioridade deve recair sobre os casos de uso de maior risco e maior escala de impacto sobre clientes, tratando o restante de forma incremental, sem paralisar a operação.